
Hub documentation
تعديل مجموعات البيانات
تعديل مجموعات البيانات
يتيح Hub التنسيق التعاوني لمجموعات بيانات المجتمع والبحث. نشجعك على استكشاف مجموعات البيانات المتاحة على Hub والمساهمة في تحسينها للمساعدة في نمو مجتمع تعلم الآلة وتسريع التقدم للجميع. جميع المساهمات مرحب بها!
ابدأ بـ إنشاء حساب على Hugging Face Hub إذا لم يكن لديك حساب بعد.
التحرير باستخدام واجهة Hub
يتوفر هذا الميزة حاليًا فقط لمجموعات البيانات بصيغ CSV وTSV وParquet.
تتيح واجهة الويب الخاصة بـ Hub للمستخدمين الذين لا يملكون أي خبرة تقنية تعديل مجموعة بيانات.
افتح صفحة مجموعة البيانات وانتقل إلى علامة التبويب Data Studio لبدء التحرير.


انقر على تبديل وضع التحرير لتفعيل تحرير مجموعة البيانات.


حرّر ما تشاء من الخلايا ثم انقر في النهاية على Commit لتأكيد تغييراتك وترك رسالة تأكيد.


استخدام مكتبة العملاء huggingface_hub
يمكن لمكتبة huggingface_hub إدارة مستودعات Hub بما في ذلك تحرير مجموعات البيانات.
على سبيل المثال، فيما يلي كيفية تحرير ملف CSV باستخدام واجهة Hugging Face FileSystem API:
from huggingface_hub import hffs

path = f"datasets/{repo_id}/data.csv"

with hffs.open(path, "r") as f:
    content = f.read()
edited_content = content.replace("foo", "bar")
with hffs.open(path, "w") as f:
    f.write(edited_content)
يمكنك أيضًا تطبيق التعديل محليًا على القرص الخاص بك والالتزام بالتغييرات:
from huggingface_hub import hf_hub_download, upload_file

local_path = hf_hub_download(repo_id=repo_id, path_in_repo= "data.csv", repo_type="dataset")

with open(path, "r") as f:
    content = f.read()
edited_content = content.replace("foo", "bar")
with open(path, "w") as f:
    f.write(edited_content)

upload_file(repo_id=repo_id, path_in_repo=local_path, repo_type="dataset")
لحفظ مستودع مجموعة البيانات بالكامل محليًا وتحرير العديد من الملفات دفعة واحدة، استخدم
snapshot_downloadوupload_folderبدلاً منhf_hub_downloadوupload_file
قم بزيارة توثيق مكتبة العميل لمعرفة المزيد.
المكتبات المتكاملة
إذا كان مجموعة بيانات على Hub متوافقة مع مكتبة مدعومة، فإن تحميل مجموعة البيانات وتعديلها ودفعها يتطلب بضع سطور فقط.
إليك كيفية تحرير ملف CSV باستخدام Pandas:
import pandas as pd

# Load the dataset
df = pd.read_csv(f"hf://datasets/{repo_id}/data.csv")

# Edit
df = df.apply(...)

# Commit the changes
df.to_csv(f"hf://datasets/{repo_id}/data.csv")
تُنفّذ مكتبات مثل Polars وDuckDB بروتوكول hf:// لقراءة الملفات على Hugging Face وتعديلها وكتابتها. كما أن مكتبات أخرى مفيدة لتحرير مجموعات البيانات المكوّنة من العديد من الملفات، مثل Spark وDask و🤗 Datasets. راجع القائمة الكاملة للمكتبات المدعومة هنا
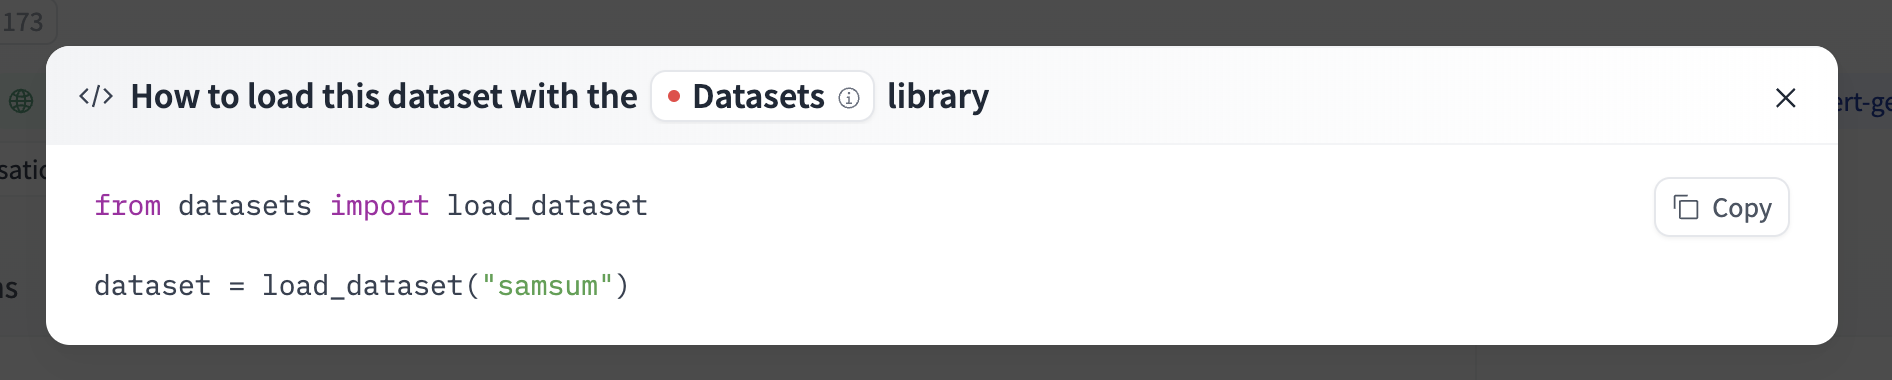
لمعرفة كيفية الوصول إلى مجموعة البيانات على الموقع، يمكنك النقر على زر “Use this dataset” في صفحة مجموعة البيانات لرؤية كيفية القيام بذلك.
على سبيل المثال، يُظهر samsum كيفية القيام بذلك باستخدام 🤗 Datasets أدناه.
ارفع البيانات الجديدة فقط
يعتمد تخزين Hugging Face على Xet، الذي يستخدم إزالة التكرار بين المقاطع لجعل عمليات الرفع أكثر كفاءة. على عكس التخزين السحابي التقليدي، لا يتطلب Xet إعادة رفع مجموعة البيانات بأكملها لالتزام التغييرات. بدلاً من ذلك، يكتشف تلقائيًا الأجزاء التي تغيّرت في مجموعة البيانات ويوجه مكتبة العميل لرفع الأجزاء المحدّثة فقط. لتنفيذ ذلك، يستخدم Xet خوارزمية ذكية للعثور على مقاطع بحجم 64kB موجودة مسبقًا على Hugging Face.
لنلقِ نظرة على مثالنا السابق باستخدام Pandas:
import pandas as pd

# Load the dataset
df = pd.read_csv(f"hf://datasets/{repo_id}/data.csv")

# Edit part of the dataset
df = df.apply(...)

# Commit the changes
df.to_csv(f"hf://datasets/{repo_id}/data.csv")
تقوم هذه الأحملة أولاً بتحميل مجموعة بيانات ثم تعديلها.
بمجرد اكتمال التعديلات، يُحوّل to_csv() الملف إلى ذاكرة، ويقسمه إلى أجزاء، ويسأل Xet عن الأجزاء الموجودة مسبقاً على Hugging Face والأجزاء التي تغيّرت، ثم يرفع البيانات الجديدة فقط.
تحرير Parquet المُحسّن
يعتمد حجم البيانات المطلوب رفعها على التعديلات وبنية الملفات.
تنسيق Parquet عمودي ومضغوط على مستوى الصفحات (حيث تبلغ حجم الصفحة حوالي 1 ميغابايت تقريبًا). قمنا بتحسين Parquet من أجل Xet باستخدام Parquet Content Defined Chunking، مما يضمن أن البيانات غير المعدلة تؤدي بشكل عام إلى صفحات غير معدلة.
على سبيل المثال، يرفع هذا الكود محتوى df ثم بالنسبة إلى edited_df يكون الرفع أسرع لأنه يرفع فقط المقاطع التي تغيّرت:
import pandas as pd

df.to_parquet(
    "hf://datasets/username/my_dataset/imdb.parquet",
    # Optimize for Xet
    use_content_defined_chunking=True,
    write_page_index=True,
)

edited_df = ...  # e.g. with added/modified/removed rows or columns

edited_df.to_parquet(
    "hf://datasets/username/my_dataset/imdb.parquet",
    # Optimize for Xet
    use_content_defined_chunking=True,
    write_page_index=True,
)
تكون المقاطع بحجم ~64kB تقريبًا، ويحفظ Parquet البيانات عمودًا تلو الآخر، لذا عمليًا هذا ما يحدث عند تحرير ملف Parquet محسّن:
- إضافة عمود جديد -> يتم رفع مقاطع العمود الجديد فقط
- إضافة/تعديل/حذف صف -> يتم رفع جزء واحد لكل عمود
وبالإضافة إلى ذلك، يتم رفع مقاطع تذييل Parquet التي تحتوي على البيانات الوصفية.
تحقق مما إذا كانت مكتبتك تدعم Parquet المُحسّن في صفحة المكتبات المدعومة.
البث
يُوصى، في حالة مجموعات البيانات الكبيرة، باستخدام المكتبات التي تدعم خاصية بثّ مجموعات البيانات لإنشاء خطوط أنابيب بثّ من الطرف إلى الطرف. في هذه الحالة، يتم تنفيذ معالجة مجموعة البيانات بشكل تدريجي مع وصول البيانات القديمة ورفع البيانات الجديدة إلى Hub.
تحقق مما إذا كانت مكتبتك تدعم البث في صفحة المكتبات المدعومة.
Update on GitHub