# InstructBLIP
## نظرة عامة
قُدِّم نموذج InstructBLIP في [InstructBLIP: Towards General-purpose Vision-Language Models with Instruction Tuning](https://huggingface.co/papers/2305.06500) بواسطة Wenliang Dai وJunnan Li وDongxu Li وAnthony Meng Huat Tiong وJunqi Zhao وWeisheng Wang وBoyang Li وPascale Fung وSteven Hoi. يستفيد InstructBLIP من بنية [BLIP-2](blip-2) لضبط التعليمات البصرية.
المستخلص من الورقة البحثية هو كالتالي:
*برزت نماذج لغوية عامة قادرة على حل مهام متنوعة في مجال اللغة مدفوعةً بخط أنابيب التدريب المسبق والتدريب على التعليمات. ومع ذلك، فإن بناء نماذج رؤية-لغة عامة يمثل تحدياً بسبب زيادة التباين في المهام الناجم عن إدخال مدخلات بصرية إضافية. وعلى الرغم من أن التدريب المسبق للرؤية-اللغة قد خضع لدراسة واسعة النطاق، إلا أن التدريب على التعليمات للرؤية-اللغة لا يزال أقل استكشافاً نسبياً. في هذه الورقة، نقوم بإجراء دراسة منهجية وشاملة حول التدريب على التعليمات للرؤية-اللغة بناءً على نماذج BLIP-2 المدرَّبة مسبقاً. قمنا بجمع مجموعة واسعة من 26 مجموعة بيانات متاحة للجمهور، وتحويلها إلى صيغة التدريب على التعليمات، وتصنيفها إلى مجموعتين: واحدة للتدريب على التعليمات ضمن نطاق الاختبار، والأخرى للتقييم الصفر-اللقطات خارج نطاق الاختبار. بالإضافة إلى ذلك، نطرح استخراج الميزات البصرية الواعي بالتعليمات، وهو أسلوب حاسم يمكّن النموذج من استخراج ميزات معلوماتية مصممة خصيصاً وفقاً للتعليمات المقدمة. تحقق نماذج InstructBLIP الناتجة عن ذلك من أداء صفر-اللقطات متقدم على مستوى الحالة الفنية عبر جميع مجموعات البيانات الـ 13 خارج نطاق الاختبار، متفوقةً بشكل كبير على BLIP-2 والنموذج الأكبر Flamingo. كما تقود نماذجنا إلى أداء متقدم على مستوى الحالة الفنية عند ضبطها الدقيق على مهام فرعية فردية (مثل دقة 90.7% في ScienceQA IMG). علاوة على ذلك، نوضح نوعياً مزايا InstructBLIP مقارنةً بنماذج متعددة الوسائط المتزامنة.*
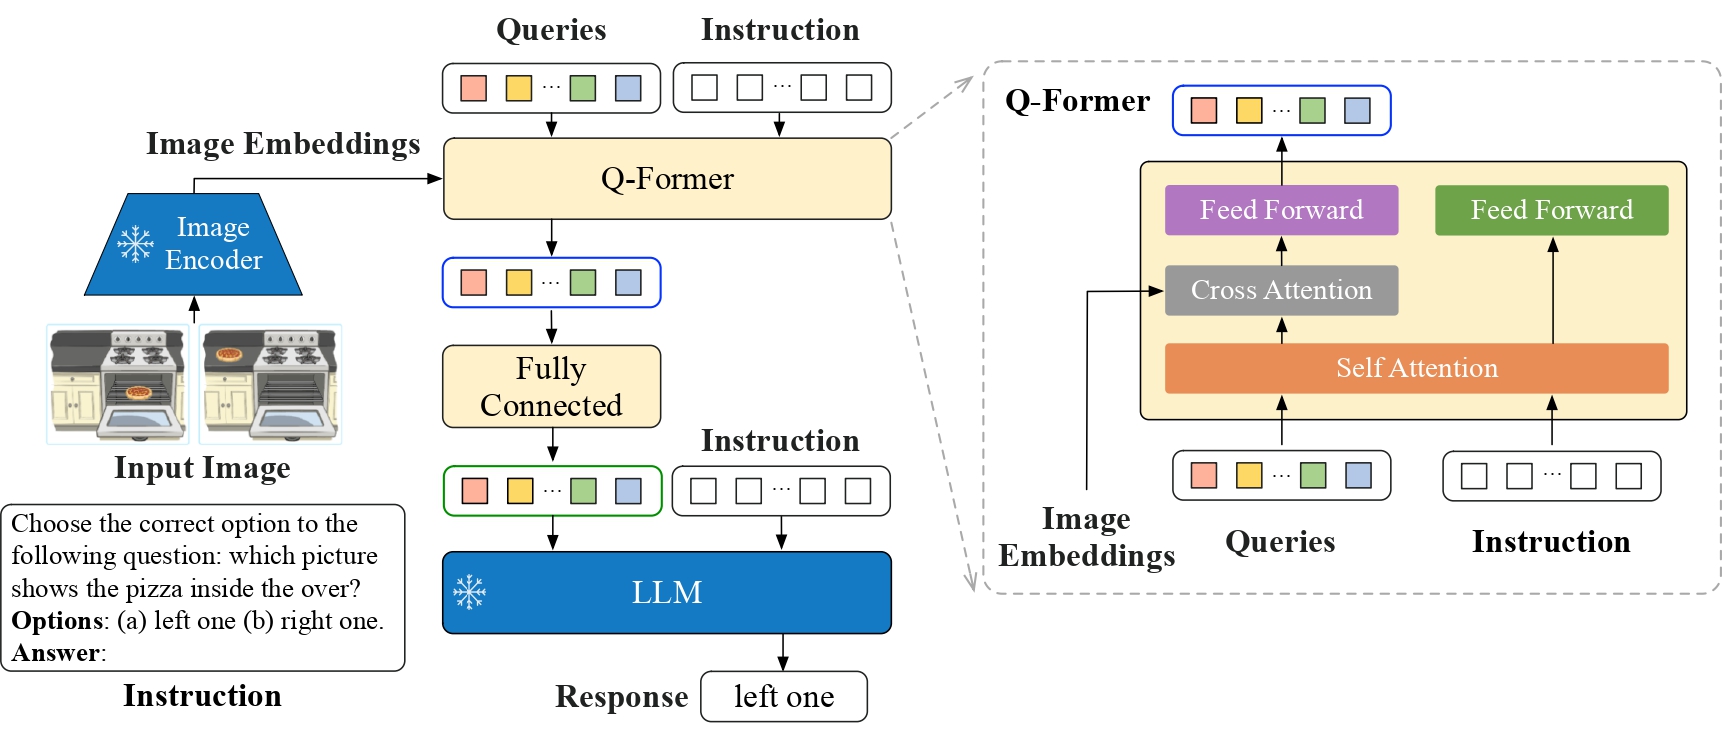 بنية InstructBLIP. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/salesforce/LAVIS/tree/main/projects/instructblip).
## نصائح للاستخدام
يستخدم InstructBLIP نفس البنية المعمارية لـ [BLIP-2](blip-2) مع فرق صغير لكنه مهم: فهو يغذي أيضًا النص التوجيهي (التعليمات) إلى Q-Former.
> [!NOTE]
> ستُصدر نماذج BLIP بعد الإصدار v4.46 تحذيرات بشأن إضافة `processor.num_query_tokens = {{num_query_tokens}}` وتوسيع طبقة التضمينات في النموذج لإضافة رمز `` الخاص. يُوصى بشدة بإضافة هذه السمات إلى المعالج إذا كنت تمتلك نقطة التفتيش للنموذج، أو فتح طلب دمج (PR) إذا لم تكن تمتلكها. إضافة هذه السمات تعني أن BLIP سيضيف عدد رموز الاستعلام المطلوبة لكل صورة، وسيمد النص بعدد من العناوين الوهمية `` مساوٍ لعدد رموز الاستعلام. عادةً يكون العدد حوالي 500 رمز لكل صورة، لذا تأكد من عدم اقتطاع النص، وإلا فسيحدث فشل عند دمج التضمينات.
يمكن الحصول على هذه السمات من إعدادات النموذج، كما في `model.config.num_query_tokens`، ويمكن توسيع تمثيلات النموذج باتباع [هذا الرابط](https://gist.github.com/zucchini-nlp/e9f20b054fa322f84ac9311d9ab67042).
## InstructBlipConfig[[transformers.InstructBlipConfig]]
#### transformers.InstructBlipConfig[[transformers.InstructBlipConfig]]
```python
transformers.InstructBlipConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, qformer_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_query_tokens: int = 32, image_token_index: int | None = None, initializer_factor: float = 1.0, initializer_range: float = 0.02)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/configuration_instructblip.py#L106)
**المعاملات:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : كائن الإعداد أو قاموس العمود الفقري البصري.
qformer_config (`dict`، *اختياري*) : قاموس لخيارات التهيئة المستخدمة لتبنيء [InstructBlipQFormerConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipQFormerConfig).
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`، *اختياري*) : كائن الإعداد أو قاموس العمود الفقري النصي.
num_query_tokens (`int`, *اختياري*, القيمة الافتراضية 32) : عدد رموز الاستعلام التي تمر عبر Transformer.
image_token_index (`int`, *اختياري*) : مؤشر رمز الصورة المستخدم كعنصر نائب للصور المدخلة.
initializer_factor (`float`، *اختياري*، القيمة الافتراضية `1.0`) : معامل لتجميع جميع مصفوفات الأوزان (يجب إبقاؤه عند 1، ويُستخدم داخليًا لاختبارات التهيئة).
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
هذه فئة الإعدادات المخزنة لإعدادات نموذج InstructBlipModel. تُستخدم لاستحداث نموذج Instructblip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import (
... InstructBlipVisionConfig,
... InstructBlipQFormerConfig,
... OPTConfig,
... InstructBlipConfig,
... InstructBlipForConditionalGeneration,
... )
>>> # Initializing a InstructBlipConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipConfig()
>>> # Initializing a InstructBlipForConditionalGeneration (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a InstructBlipConfig from a InstructBlipVisionConfig, InstructBlipQFormerConfig and any PreTrainedConfig
>>> # Initializing InstructBLIP vision, InstructBLIP Q-Former and language model configurations
>>> vision_config = InstructBlipVisionConfig()
>>> qformer_config = InstructBlipQFormerConfig()
>>> text_config = OPTConfig()
>>> config = InstructBlipConfig(vision_config=vision_config, qformer_config=qformer_config, text_config=text_config)
```
## InstructBlipVisionConfig[[transformers.InstructBlipVisionConfig]]
#### transformers.InstructBlipVisionConfig[[transformers.InstructBlipVisionConfig]]
```python
transformers.InstructBlipVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 1408, intermediate_size: int = 6144, num_hidden_layers: int = 39, num_attention_heads: int = 16, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 14, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/configuration_instructblip.py#L29)
**المعاملات:**
hidden_size (`int`, *اختياري*, القيمة الافتراضية هي `1408`) : بعد التمثيلات المخفية.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `6144`) : بُعد تمثيلات MLP.
num_hidden_layers (`int`، *اختياري*، الافتراضي هو `39`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `16`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `224`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `14`) : حجم (دقة) كل رقعة.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
layer_norm_eps (`float`, *اختياري*, الافتراضي هو `1e-06`) : قيمة إيبسلون المستخدمة في طبقات تطبيع الطبقة.
attention_dropout (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`, *اختياري*, القيمة الافتراضية `1e-10`) : انحراف المعيار لـ truncated_normal_initializer لتهيئة جميع مصفوفات الأوزان.
qkv_bias (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم.
هذه فئة الإعدادات المخزنة لإعدادات نموذج InstructBlipModel. تُستخدم لاستحداث نموذج Instructblip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import InstructBlipVisionConfig, InstructBlipVisionModel
>>> # Initializing a InstructBlipVisionConfig with Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipVisionConfig()
>>> # Initializing a InstructBlipVisionModel (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipQFormerConfig[[transformers.InstructBlipQFormerConfig]]
#### transformers.InstructBlipQFormerConfig[[transformers.InstructBlipQFormerConfig]]
```python
transformers.InstructBlipQFormerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 512, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, pad_token_id: int | None = 0, cross_attention_frequency: int = 2, encoder_hidden_size: int = 1408)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/configuration_instructblip.py#L64)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `30522`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
hidden_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات (embeddings) والمُشفِّر (encoder) والمُجمِّع (pooler).
attention_probs_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.1`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `512`) : أقصى طول تسلسل قد يُستخدم مع هذا النموذج.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-12`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
pad_token_id (`int`، *اختياري*، القيمة الافتراضية `0`) : معرّف الرمز المستخدم للتعبئة في المفردات.
cross_attention_frequency (`int`, *اختياري*, القيمة الافتراضية 2) : تكرار إضافة الانتباه المتقاطع إلى طبقات Transformer.
encoder_hidden_size (`int`، *اختياري*، القيمة الافتراضية 1408) : حجم الحالة المخفية لحالات الاختباء في الانتباه المتقاطع.
هذه فئة الإعدادات المخزنة لإعدادات نموذج InstructBlipModel. تُستخدم لاستحداث نموذج Instructblip وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن استحداث إعدادات باستخدام القيم الافتراضية سيؤدي إلى إعدادات مشابهة لتلك الخاصة بـ [Salesforce/instructblip-flan-t5-xl](https://huggingface.co/Salesforce/instructblip-flan-t5-xl)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
أمثلة:
```python
>>> from transformers import InstructBlipQFormerConfig, InstructBlipQFormerModel
>>> # Initializing a InstructBLIP Salesforce/instructblip-flan-t5-xl style configuration
>>> configuration = InstructBlipQFormerConfig()
>>> # Initializing a model (with random weights) from the Salesforce/instructblip-flan-t5-xl style configuration
>>> model = InstructBlipQFormerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## InstructBlipProcessor[[transformers.InstructBlipProcessor]]
#### transformers.InstructBlipProcessor[[transformers.InstructBlipProcessor]]
```python
transformers.InstructBlipProcessor(image_processor, tokenizer, qformer_tokenizer, num_query_tokens = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/processing_instructblip.py#L30)
**المعاملات:**
image_processor (`BlipImageProcessor`) : معالج الصور هو مدخل إلزامي.
tokenizer (`GPT2Tokenizer`) : المُقسِّم هو مدخل إلزامي.
qformer_tokenizer (`AutoTokenizer`) : نسخة من ['PreTrainedTokenizer`']. مُجزِّئ Q-Former هو مدخل مطلوب.
num_query_tokens (`int`، *اختياري*) : " عدد الرموز التي يستخدمها Qformer كاستعلامات، ويجب أن يكون مطابقًا لذلك الموجود في إعدادات النموذج.
ينشئ InstructBlipProcessor الذي يجمع معالج الصور ومعالج الرموز ومعالج رموز qformer في معالج واحد.
يوفر [InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor) جميع وظائف [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor) و[GPT2Tokenizer](/docs/transformers/v5.23.0/ar/model_doc/gpt2#transformers.GPT2Tokenizer) و`{qformer_tokenizer_class}`. راجع [~BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor) و[~GPT2Tokenizer](/docs/transformers/v5.23.0/ar/model_doc/gpt2#transformers.GPT2Tokenizer) و`~{qformer_tokenizer_class}` لمزيد من المعلومات.
#### __call__[[transformers.InstructBlipProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/processing_instructblip.py#L52)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *اختياري*) : الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا مررت مدخلات مُجزَّأة مسبقًا، فاضبط `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة في دفعات.
return_mm_token_type_ids (`bool`, *kwargs*) : ما إذا كان يجب إرجاع معرّفات أنواع الرموز متعددة الوسائط التي تشير إلى مواضع رموز الحشو متعددة الوسائط.
return_text_replacement_offsets (`bool`، *kwargs*) : ما إذا كان يجب إرجاع إزاحات الأحرف لكل عنصر نائب متعدد الوسائط (multimodal placeholder) وعنصر الاستبدال الخاص به.
return_tensors (`str` أو [TensorType](/docs/transformers/v5.23.0/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ar/main_classes/processors#transformers.ProcessingKwargs)، *اختياري*) : خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
## InstructBlipVisionModel[[transformers.InstructBlipVisionModel]]
#### transformers.InstructBlipVisionModel[[transformers.InstructBlipVisionModel]]
```python
transformers.InstructBlipVisionModel(config: InstructBlipVisionConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L392)
#### forward[[transformers.InstructBlipVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L412)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor). راجع [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor) يستخدم [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor) لمعالجة الصور).
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) والمدخلات.
تتجاوز طريقة [InstructBlipVisionModel](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipVisionModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
## InstructBlipQFormerModel[[transformers.InstructBlipQFormerModel]]
#### transformers.InstructBlipQFormerModel[[transformers.InstructBlipQFormerModel]]
```python
transformers.InstructBlipQFormerModel(config: InstructBlipQFormerConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L760)
Querying Transformer (Q-Former)، المستخدم في InstructBLIP. تم تعديله قليلاً عن BLIP-2 لأنه يستقبل التعليمات أيضاً كمدخلات.
#### forward[[transformers.InstructBlipQFormerModel.forward]]
```python
forward(input_ids: LongTensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, query_embeds: typing.Optional[torch.Tensor] = None, encoder_hidden_states: typing.Optional[torch.Tensor] = None, encoder_attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L799)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`) : مؤشرات رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على المؤشرات باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
position_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس مواضع رموز كل تسلسل إدخال في تضمينات المواضع. يتم اختيارها من النطاق `[0, config.n_positions - 1]`. [ما هي معرّفات المواضع؟](../glossary#position-ids)
query_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) : حالات مخفية تُستخدم في حساب الانتباه. في حالة الانتباه المتقاطع، ستُستخدم للاستعلام (أي أن المفتاح والقيمة ستستخدم encoder_hidden_states).
encoder_hidden_states (`torch.Tensor` بأبعاد `(batch_size, sequence_length, hidden_size)`، *اختياري*) : تسلسل من الحالات المخفية عند مخرجات الطبقة الأخيرة من المُشفِّر. يُستخدم في الانتباه المتقاطع إذا كان النموذج مُهيأً كمُفكِّك.
encoder_attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنُّب تنفيذ الانتباه على فهارس رموز الحشو في مدخلات المُشفِّر. يُستخدم هذا القناع في الانتباه المتقاطع إذا كان النموذج مُهيَّأً كمُفكِّك. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنَّعة**، - 0 للرموز التي **مقنَّعة**.
**يعيد:** [BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPoolingAndCrossAttentions](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions) أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) والمدخلات.
تتجاوز طريقة [InstructBlipQFormerModel](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipQFormerModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **cross_attentions** (`tuple(torch.Tensor)`, *اختياري*, يُعاد عند تمرير `output_attentions=True` مع `config.add_cross_attention=True` أو عند `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بشكل `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه في طبقة الانتباه المتقاطع للمفكّك، بعد softmax للانتباه، وتُستخدم لحساب المتوسط المرجّح في رؤوس الانتباه المتقاطع.
- **past_key_values** (`Cache`، *اختياري*، يُعاد عند تمرير `use_cache=True` أو عند تعيين `config.use_cache=True`) -- هو كائن من نوع [Cache](/docs/transformers/v5.23.0/ar/internal/generation_utils#transformers.Cache). لمزيد من التفاصيل، راجع [دليل ذاكرة kv](https://huggingface.co/docs/transformers/en/kv_cache).
تحتوي على حالات مخفية محسوبة مسبقًا (المفاتيح والقيم في كتل الانتباه الذاتي، وفي كتل الانتباه المتقاطع اختياريًا إذا كان `config.is_encoder_decoder=True`) يمكن استخدامها (انظر مدخل `past_key_values`) لتسريع فك الترميز التسلسلي.
## InstructBlipModel[[transformers.InstructBlipModel]]
#### transformers.InstructBlipModel[[transformers.InstructBlipModel]]
```python
transformers.InstructBlipModel(config: InstructBlipConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L867)
**المعاملات:**
config ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج InstructBLIP الأساسي المكوّن من نموذج لغوي ووحدة qformer ومشفّر بصري.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.InstructBlipModel.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L919)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor). راجع [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor) يستخدم [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor) لمعالجة الصور).
qformer_input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في مفردات نموذج Q-Former. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي، حيث يقوم نموذج Q-Former بتشفيرها. يمكن الحصول على الفهارس باستخدام [InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor). راجع [InstructBlipProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنّب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز **غير المقنّعة**، - 0 للرموز **المقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` of shape `(batch_size, target_sequence_length)`, *اختياري*) : مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس النموذج. يمكن الحصول على المؤشرات باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات مدخلات المُفكِّك؟](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` of shape `(batch_size, target_sequence_length)`, *اختياري*) : السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو في `decoder_input_ids`. سيتم استخدام القناع السببي أيضًا بشكل افتراضي. لا ينطبق إلا في حالة استخدام نموذج لغوي مشفّر-مفكّك (مثل T5).
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `InstructBlipForConditionalGenerationModelOutput` أو `tuple(torch.Tensor)`
`InstructBlipForConditionalGenerationModelOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتمادًا على الإعداد ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) والمدخلات.
تتجاوز طريقة [InstructBlipModel](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor`, *اختياري*, يُعاد عند تقديم `labels`, `torch.Tensor` بشكل `(1,)`) -- خسارة نمذجة اللغة من نموذج اللغة.
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة في نموذج اللغة.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *اختياري*) -- مخرجات مُرمِّز الرؤية.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`، *اختياري*) -- مخرجات Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` أو `Seq2SeqLMOutput`) -- مخرجات نموذج اللغة.
#### get_placeholder_mask[[transformers.InstructBlipModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L904)
يحصل على قناع العنصر الوهمي متعدد الوسائط من `input_ids` أو `inputs_embeds`.
## InstructBlipForConditionalGeneration[[transformers.InstructBlipForConditionalGeneration]]
#### transformers.InstructBlipForConditionalGeneration[[transformers.InstructBlipForConditionalGeneration]]
```python
transformers.InstructBlipForConditionalGeneration(config: InstructBlipConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1028)
**المعاملات:**
config ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج InstructBLIP لتوليد النص بناءً على صورة وموجّه نصي اختياري. يتكوّن النموذج من مُشفِّر بصري، ومحوّل الاستعلام (Q-Former)، ونموذج لغوي.
يمكن تمرير `input_ids` إلى النموذج بشكل اختياري، حيث تعمل كموجّه نصّي، لجعل نموذج اللغة يستمر في إكمال الموجّه. وإلا، يبدأ نموذج اللغة بتوليد النص من رمز [BOS] (بداية التسلسل).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.InstructBlipForConditionalGeneration.forward]]
```python
forward(pixel_values: Tensor, qformer_input_ids: Tensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, decoder_input_ids: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1174)
**المعاملات:**
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المتناظرة مع الصور المدخلة. يمكن الحصول على قيم البكسل باستخدام [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor). راجع [BlipImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor) يستخدم [BlipImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/blip#transformers.BlipImageProcessor) لمعالجة الصور).
qformer_input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في مفردات نموذج Q-Former. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي، حيث يقوم نموذج Q-Former بتشفيرها. يمكن الحصول على الفهارس باستخدام [InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor). راجع [InstructBlipProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
input_ids (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنّب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز **غير المقنّعة**، - 0 للرموز **المقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
decoder_input_ids (`torch.LongTensor` of shape `(batch_size, target_sequence_length)`, *اختياري*) : مؤشرات رموز تسلسل مدخلات المُفكِّك في قاموس النموذج. يمكن الحصول على المؤشرات باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات مدخلات المُفكِّك؟](../glossary#decoder-input-ids)
decoder_attention_mask (`torch.BoolTensor` of shape `(batch_size, target_sequence_length)`, *اختياري*) : السلوك الافتراضي: توليد متجه يتجاهل رموز الحشو في `decoder_input_ids`. سيتم استخدام القناع السببي أيضًا بشكل افتراضي. لا ينطبق إلا في حالة استخدام نموذج لغوي مشفّر-مفكّك (مثل T5).
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات لحساب خسارة نمذجة اللغة. يجب أن تكون الفهارس ضمن `[-100, 0, ..., config.vocab_size - 1]`. يتم تجاهل (إخفاء) جميع التسميات المضبوطة على `-100`، ولا تُحسب الخسارة إلا للتسميات ضمن `[0, ..., config.vocab_size]`
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`، *اختياري*) : قاموس حيث تكون المفاتيح هي الأنماط المدعومة والقيم هي المخرجات المُرمّزة لذلك النمط. كل مخرَج مُرمّز هو مجموعة (tuple) تتكون من (`pooler_output`، *اختياري*: `last_hidden_states`، *اختياري*: `hidden_states`، *اختياري*: `attentions`) `pooler_output` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) وهو تسلسل من الميزات متعددة الوسائط للمُشفِّر المُدمجة في تضمينات النص.
**يعيد:** `InstructBlipForConditionalGenerationModelOutput` أو `tuple(torch.Tensor)`
`InstructBlipForConditionalGenerationModelOutput` أو مجموعة مرتبة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتمادًا على الإعداد ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) والمدخلات.
تتجاوز طريقة [InstructBlipForConditionalGeneration](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipForConditionalGeneration) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor`, *اختياري*, يُعاد عند تقديم `labels`, `torch.Tensor` بشكل `(1,)`) -- خسارة نمذجة اللغة من نموذج اللغة.
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة في نموذج اللغة.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *اختياري*) -- مخرجات مُرمِّز الرؤية.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`، *اختياري*) -- مخرجات Q-Former (Querying Transformer).
- **language_model_outputs** (`CausalLMOutputWithPast` أو `Seq2SeqLMOutput`) -- مخرجات نموذج اللغة.
أمثلة:
```python
>>> from transformers import InstructBlipProcessor, InstructBlipForConditionalGeneration
>>> import torch
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> processor = InstructBlipProcessor.from_pretrained("Salesforce/instructblip-vicuna-7b")
>>> device = "cuda" if torch.cuda.is_available() else "cpu"
>>> model.to(device)
>>> url = "https://huggingface.co/datasets/hf-internal-testing/transformers-synthetic-assets/resolve/main/images/lavis_confusing_pictures.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> prompt = "What is unusual about this image?"
>>> inputs = processor(images=image, text=prompt, return_tensors="pt").to(device)
>>> outputs = model.generate(
... **inputs,
... do_sample=False,
... num_beams=5,
... max_length=256,
... min_length=1,
... top_p=0.9,
... repetition_penalty=1.5,
... length_penalty=1.0,
... temperature=1,
... )
>>> generated_text = processor.batch_decode(outputs, skip_special_tokens=True)[0].strip()
>>> print(generated_text)
The unusual aspect of this image is that a man is ironing clothes on the back of a yellow SUV, which is parked in the middle of a busy city street. This is an unconventional approach to ironing clothes, as it requires the man to balance himself and his ironing equipment on top of the vehicle while navigating through traffic. Additionally, the presence of taxis and other vehicles in the scene further emphasizes the unusual nature of this situation.
```
#### generate[[transformers.InstructBlipForConditionalGeneration.generate]]
```python
generate(pixel_values: Tensor, qformer_input_ids: typing.Optional[torch.LongTensor] = None, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **generate_kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1313)
**المعاملات:**
pixel_values (`torch.Tensor` بأبعاد (batch_size, num_channels, height, width)): صور الإدخال المراد معالجتها.
qformer_input_ids (`torch.LongTensor` من الشكل (batch_size, sequence_length)، *اختياري*) : التسلسل المستخدم كموجّه يُغذّى إلى وحدة Q-Former.
qformer_attention_mask (`torch.LongTensor` من الشكل (batch_size, sequence_length)، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو.
input_ids (`torch.LongTensor` بأبعاد (batch_size, sequence_length)، *اختياري*) : التسلسل المستخدم كموجّه للتوليد.
attention_mask (`torch.LongTensor` من الشكل (batch_size, sequence_length)، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو.
inputs_embeds (`torch.Tensor` بأبعاد `(batch_size, sequence_length, hidden_size)`) : تمثيل مضمّن للمدخلات. يجب أن تكون من نوع float وليس رموز int.
interpolate_pos_encoding (`bool`, *اختياري*, الافتراضي هو `False`) : ما إذا كان سيتم استيفاء الترميز الموضعي لتضمينات الصور.
**يعيد:** `captions (list)`
قائمة من السلاسل النصية بطول batch_size * num_captions.
يتجاوز دالة `generate` ليتمكّن من استخدام النموذج كمولّد مشروط.
#### get_image_features[[transformers.InstructBlipForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, qformer_input_ids: LongTensor, qformer_attention_mask: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool | None = False, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/instructblip/modeling_instructblip.py#L1091)
**المعاملات:**
pixel_values (`torch.Tensor` بأبعاد `(batch_size, num_channels, image_size, image_size)`) : المصفوفات المقابلة للصور المدخلة.
qformer_input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في مفردات نموذج Q-Former. يمكن تقديم رموز الإدخال اختيارياً لتعمل كموجّه نصي، حيث يقوم نموذج Q-Former بتشفيرها. يمكن الحصول على الفهارس باستخدام [InstructBlipProcessor](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor). راجع [InstructBlipProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipProcessor.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
qformer_attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
interpolate_pos_encoding (`bool`، *اختياري*، القيمة الافتراضية `False`) : ما إذا كان سيتم استيفاء ترميزات المواقع المُدرَّبة مسبقًا.
**يعيد:** `BaseModelOutputWithVisionQformerOutputs` أو `tuple(torch.Tensor)`
`BaseModelOutputWithVisionQformerOutputs` أو مجموعة من `torch.Tensor` (إذا تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([InstructBlipConfig](/docs/transformers/v5.23.0/ar/model_doc/instructblip#transformers.InstructBlipConfig)) والمدخلات.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
- **vision_outputs** (`~modeling_outputs.BaseModelOutputWithPooling`, *اختياري*) -- مخرجات مُرمِّز الرؤية.
- **qformer_outputs** (`~modeling_outputs.BaseModelOutputWithPoolingAndCrossAttentions`، *اختياري*) -- مخرجات Q-Former (Querying Transformer).
مثال:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, InstructBlipForConditionalGeneration
>>> model = InstructBlipForConditionalGeneration.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> processor = AutoProcessor.from_pretrained("Salesforce/instructblip-flan-t5-xl")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```