# Grounding DINO
## Обзор
Модель Grounding DINO была предложена в статье [Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection](https://huggingface.co/papers/2303.05499) авторами Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, Hao Zhang, Jie Yang, Chunyuan Li, Jianwei Yang, Hang Su, Jun Zhu, Lei Zhang. Grounding DINO расширяет модель обнаружения объектов с закрытым набором классификаторов текстовым энкодером, что позволяет выполнять обнаружение объектов с открытым набором. Модель демонстрирует выдающиеся результаты, например, 52.5 AP на COCO в режиме zero-shot.
Аннотация из статьи следующая:
*В данной статье мы представляем детектор объектов открытого множества, названный Grounding DINO, который объединяет детектор на основе Transformer — DINO — с предобучением с привязкой к контексту (grounded pre-training) и способен обнаруживать произвольные объекты по входным данным человека, таким как названия категорий или описательные выражения. Ключевое решение задачи обнаружения объектов открытого множества заключается во введении языка в детектор закрытого множества для обобщения на концепции открытого множества. Чтобы эффективно объединить языковой и визуальный модальности, мы концептуально разбиваем детектор закрытого множества на три этапа и предлагаем решение с тесным слиянием, включающее усилитель признаков, выбор запросов под руководством языка и декодер для слияния между модальностями. В то время как предыдущие работы в основном оценивали обнаружение объектов открытого множества на новых категориях, мы предлагаем также проводить оценку на понимании описательных выражений для объектов, заданных с атрибутами. Grounding DINO демонстрирует выдающиеся результаты во всех трёх сценариях, включая бенчмарки на COCO, LVIS, ODinW и RefCOCO/+/g. Grounding DINO достигает 52.5 AP на бенчмарке COCO для zero-shot переноса в задаче обнаружения, то есть без использования каких-либо обучающих данных из COCO. Он устанавливает новый рекорд на zero-shot бенчмарке ODinW со средним значением 26.1 AP.*
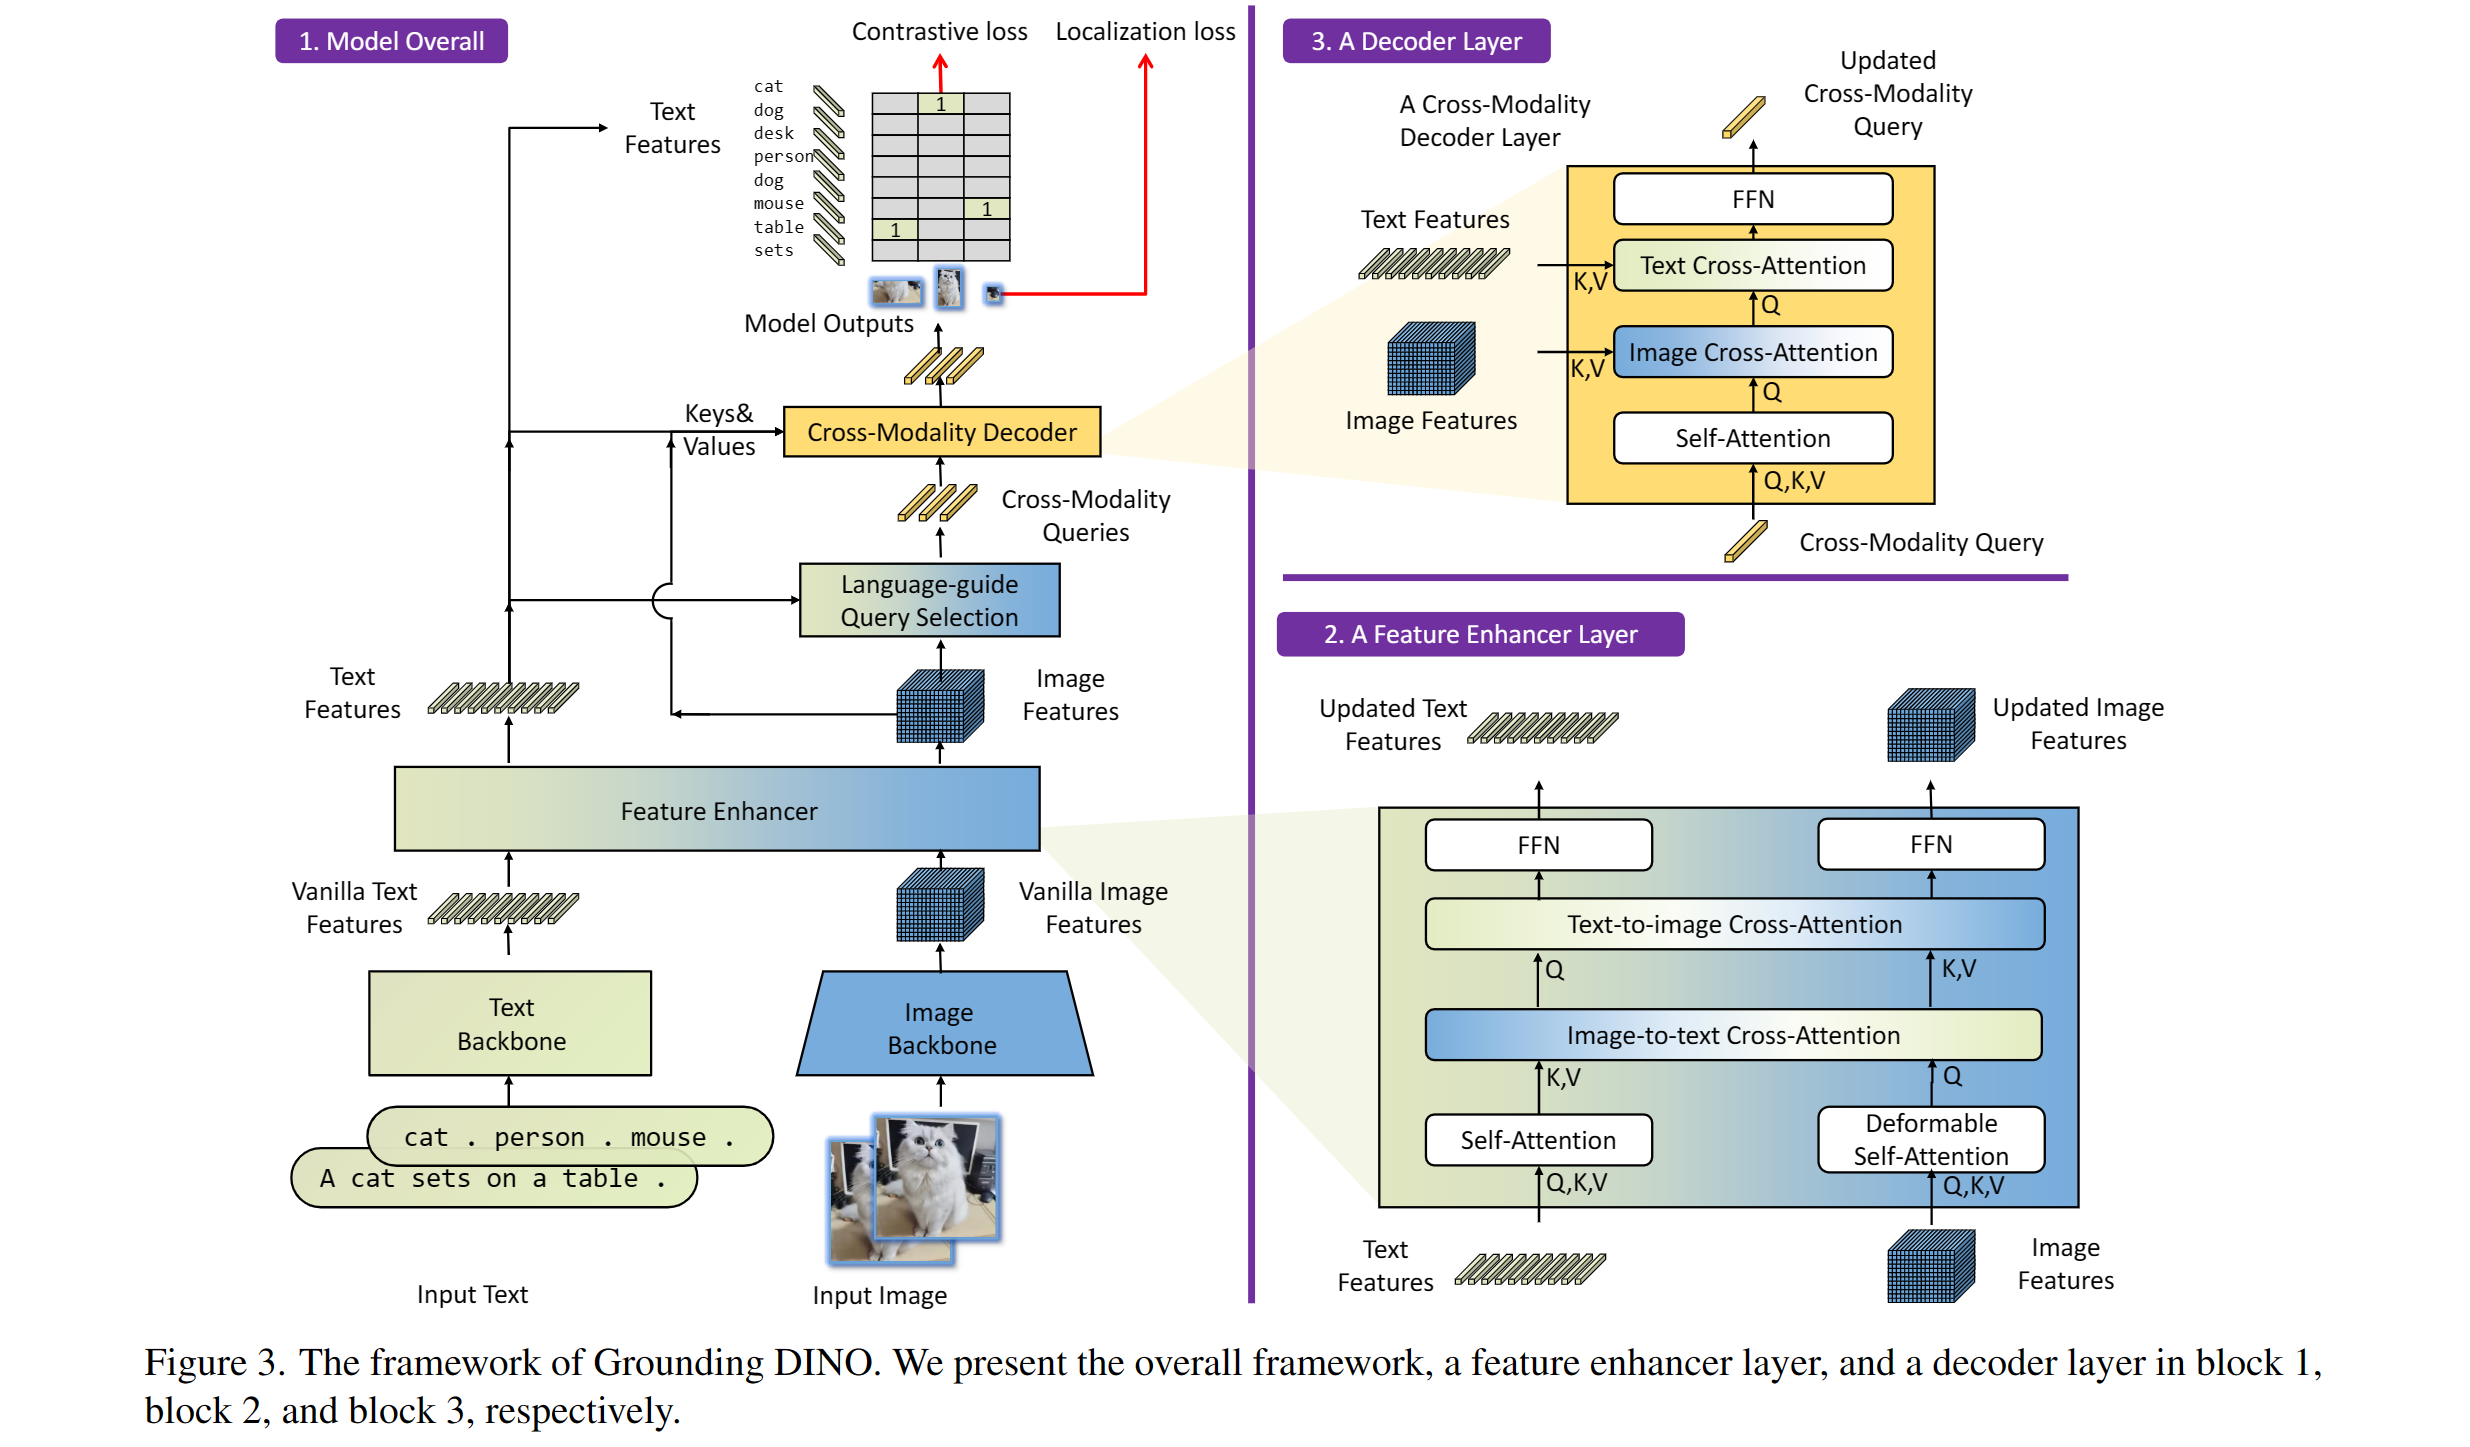 Обзор Grounding DINO. Источник — оригинальная статья.
Эта модель была добавлена [EduardoPacheco](https://huggingface.co/EduardoPacheco) и [nielsr](https://huggingface.co/nielsr). Исходный код можно найти [здесь](https://github.com/IDEA-Research/GroundingDINO).
## Советы по использованию
- Для подготовки пар «изображение-текст» для модели можно использовать [GroundingDinoProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoProcessor).
- Для разделения классов в тексте используйте точку, например: "a cat. a dog."
- При использовании нескольких классов (например, `"a cat. a dog."`) для постобработки выходов используйте `post_process_grounded_object_detection` из [GroundingDinoProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoProcessor). Это связано с тем, что метки, возвращаемые `post_process_object_detection`, представляют собой индексы из размерности модели, где prob > threshold.
Вот как использовать модель для обнаружения объектов в режиме zero-shot:
```python
import requests
import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")
image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]
inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
threshold=0.4,
text_threshold=0.3,
target_sizes=[image.size[::-1]]
)
# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
box = [round(x, 2) for x in box.tolist()]
print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
```
## Grounded SAM
Модель Grounding DINO можно объединить с моделью [Segment Anything](sam) для генерации масок по текстовому запросу, как описано в статье [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Подробности можно найти в этой [демо-тетради](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍.
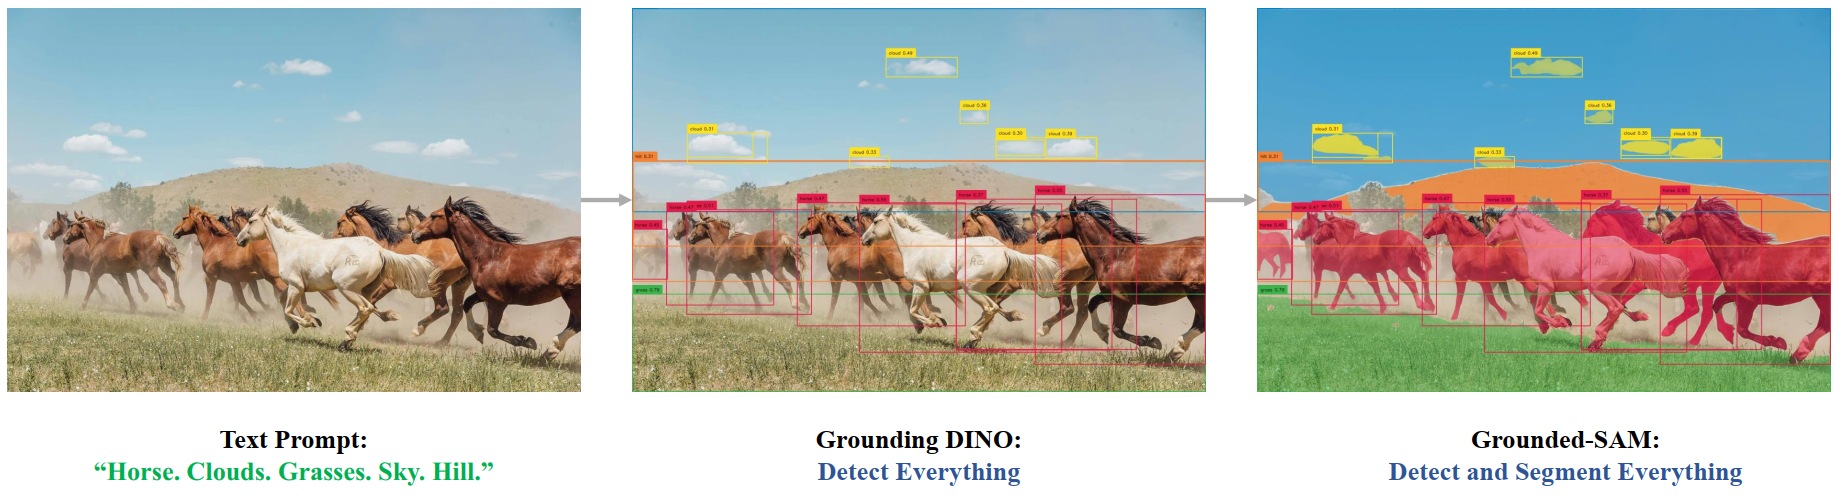 Обзор Grounded SAM. Изображение взято из исходного репозитория.
## Ресурсы
Список официальных ресурсов Hugging Face и сообщества (отмечены 🌎), которые помогут вам начать работу с Grounding DINO. Если вы хотите предложить ресурс для включения в этот список, пожалуйста, создайте Pull Request, и мы его рассмотрим! В идеале ресурс должен демонстрировать что-то новое, а не дублировать существующие материалы.
- Демо-ноутбуки, посвящённые инференсу с Grounding DINO, а также его сочетанию с [SAM](sam), можно найти [здесь](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Grounding%20DINO). 🌎
## GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
#### transformers.GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
```python
transformers.GroundingDinoImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L308)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 800, 'longest_edge': 1333}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью GROUNDING_DINO. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
Создаёт процессор изображений GroundingDinoImageProcessor.
#### preprocess[[transformers.GroundingDinoImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L563)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
annotations (`AnnotationType` или `list[AnnotationType]`, *необязательный*) : Аннотации, которые необходимо преобразовать в соответствии с применяемым к изображениям выравниванием (padding).
return_segmentation_masks (`bool`, *необязательный*, по умолчанию `self.return_segmentation_masks`) : Нужно ли возвращать маски сегментации.
masks_path (`str` или `pathlib.Path`, *необязательный*) : Путь к каталогу, содержащему маски сегментации.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью GROUNDING_DINO. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
## GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
#### transformers.GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
```python
transformers.GroundingDinoImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L300)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'shortest_edge' : 800, 'longest_edge': 1333}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `2`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.485, 0.456, 0.406]`) : Средние значения изображения, используемые для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.229, 0.224, 0.225]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли дополнять изображение. Дополнение выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия дополнения зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью GROUNDING_DINO. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
Создаёт процессор изображений GroundingDinoImageProcessor.
#### preprocess[[transformers.GroundingDinoImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L568)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
annotations (`AnnotationType` или `list[AnnotationType]`, *необязательный*) : Аннотации, которые необходимо преобразовать в соответствии с применяемым к изображениям выравниванием (padding).
return_segmentation_masks (`bool`, *необязательный*, по умолчанию `self.return_segmentation_masks`) : Нужно ли возвращать маски сегментации.
masks_path (`str` или `pathlib.Path`, *необязательный*) : Путь к каталогу, содержащему маски сегментации.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
format (`str`, *kwargs*, *optional*, по умолчанию `AnnotationFormat.COCO_DETECTION`) : Формат данных аннотаций. Одно из значений "coco_detection" или "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Управляет преобразованием аннотаций в формат, ожидаемый моделью GROUNDING_DINO. Преобразует ограничивающие рамки в формат `(center_x, center_y, width, height)` в диапазоне `[0, 1]`. Может быть переопределено параметром `do_convert_annotations` в методе `preprocess`.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
#### post_process_object_detection[[transformers.GroundingDinoImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: GroundingDinoObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L713)
**Параметры:**
outputs (`GroundingDinoObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *optional*, по умолчанию 0.1) : Порог оценки для сохранения предсказаний обнаружения объектов.
target_sizes (`torch.Tensor` или `list[tuple[int, int]]`, *необязательный*) : тензор формы `(batch_size, 2)` или список кортежей (`tuple[int, int]`), содержащих целевой размер `(height, width)` каждого изображения в батче. Если не задано, предсказания не будут изменены в размере.
**Возвращает:** `list[Dict]`
Список словарей, каждый из которых содержит следующие ключи:
- Уровень уверенности для каждого предсказанного прямоугольника на изображении.
- "labels": Индексы классов, предсказанных моделью на изображении.
- "boxes": ограничивающие рамки изображений в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Преобразует необработанный вывод [GroundingDinoForObjectDetection](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) в итоговые ограничивающие прямоугольники в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
## GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
#### transformers.GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
```python
transformers.GroundingDinoProcessor(image_processor, tokenizer)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L115)
**Параметры:**
image_processor (`GroundingDinoImageProcessor`) : процессор изображений является обязательным входным параметром.
tokenizer (`BertTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт GroundingDinoProcessor, который объединяет процессор изображений и токенизатор в единый процессор.
[GroundingDinoProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoProcessor) предоставляет все возможности [GroundingDinoImageProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) и [BertTokenizer](/docs/transformers/main/ru/model_doc/lxmert#transformers.BertTokenizer). Подробнее см. в документации [~GroundingDinoImageProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) и [~BertTokenizer](/docs/transformers/main/ru/model_doc/lxmert#transformers.BertTokenizer).
#### __call__[[transformers.GroundingDinoProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L653)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаёте предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Видео для предобработки. Ожидается одно видео или батч видео со значениями пикселей в диапазоне от 0 до 255. Если передаются видео со значениями пикселей от 0 до 1, установите `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *необязательный*) : Аудио или пакет аудио для подготовки. Каждое аудио может быть массивом NumPy или тензором PyTorch. В случае массива NumPy/тензора PyTorch каждое аудио должно иметь форму (C, T), где C — количество каналов, а T — длина выборки аудио.
return_tensors (`str` или [TensorType](/docs/transformers/main/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ru/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
#### post_process_grounded_object_detection[[transformers.GroundingDinoProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: GroundingDinoObjectDetectionOutput, input_ids: transformers.utils.generic.TensorType | None = None, threshold: float = 0.25, text_threshold: float = 0.25, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L143)
**Параметры:**
outputs (`GroundingDinoObjectDetectionOutput`) : Сырые выходные данные модели.
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Идентификаторы токенов входного текста. Если не указаны, будут взяты из вывода модели.
threshold (`float`, *optional*, по умолчанию 0.25) : Порог для сохранения предсказаний обнаружения объектов на основе оценки уверенности.
text_threshold (`float`, *optional*, по умолчанию 0.25) : Порог оценки для сохранения предсказаний обнаружения текста.
target_sizes (`torch.Tensor` или `list[tuple[int, int]]`, *необязательный*) : тензор формы `(batch_size, 2)` или список кортежей (`tuple[int, int]`), содержащих целевой размер `(height, width)` каждого изображения в батче. Если не задано, предсказания не будут изменены в размере.
text_labels (`list[list[str]]`, *необязательный*) : Список кандидатов меток, которые необходимо обнаружить на каждом изображении. В настоящее время он *НЕ используется*, но требуется в сигнатуре конвейера zero-shot object detection. Текстовые метки извлекаются из тензора `input_ids`, переданного в `outputs`.
**Возвращает:** `list[Dict]`
Список словарей, каждый из которых содержит
- **scores**: тензор с оценками уверенности для обнаруженных объектов
- **boxes**: тензор ограничивающих прямоугольников в формате [x0, y0, x1, y1]
- **labels**: список текстовых меток для каждого обнаруженного объекта (в v4.51.0 будет заменён на целочисленные идентификаторы)
- **text_labels**: список текстовых меток для обнаруженных объектов
Преобразует необработанный вывод [GroundingDinoForObjectDetection](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) в итоговые ограничивающие прямоугольники в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y) и получает соответствующие текстовые метки.
## GroundingDinoConfig[[transformers.GroundingDinoConfig]]
#### transformers.GroundingDinoConfig[[transformers.GroundingDinoConfig]]
```python
transformers.GroundingDinoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_queries: int = 900, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = True, class_cost: float = 1.0, bbox_cost: float = 5.0, giou_cost: float = 2.0, bbox_loss_coefficient: float = 5.0, giou_loss_coefficient: float = 2.0, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, max_text_len: int = 256, text_enhancer_dropout: float | int = 0.0, fusion_droppath: float | int = 0.1, fusion_dropout: float | int = 0.0, embedding_init_target: bool = True, query_dim: int = 4, decoder_bbox_embed_share: bool = True, two_stage_bbox_embed_share: bool = False, positional_embedding_temperature: int = 20, init_std: float = 0.02, layer_norm_eps: float = 1e-05, tie_word_embeddings: bool = True)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/configuration_grounding_dino.py#L28)
**Параметры:**
is_encoder_decoder (`bool`, *необязательный*, по умолчанию `True`) : Используется ли модель в качестве энкодера/декодера.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Конфигурация базовой модели.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь текстового бэкбона.
num_queries (`int`, *optional*, по умолчанию 900) : Количество запросов объектов, то есть слотов для обнаружения. Это максимальное число объектов, которые [GroundingDinoModel](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoModel) может обнаружить на одном изображении.
encoder_layers (`int`, *необязательный*, по умолчанию `6`) : Количество скрытых слоев в кодере Transformer. Если не задано, будет использовано то же значение, что и у `num_layers`.
encoder_ffn_dim (`int`, *optional*, по умолчанию `2048`) : Размерность «промежуточного» (часто называемого feed-forward) слоя в энкодере.
encoder_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в кодере Transformer.
decoder_layers (`int`, *необязательный*, по умолчанию `6`) : Количество скрытых слоев в декодере Transformer. Если не задано, будет использовано то же значение, что и у `num_layers`.
decoder_ffn_dim (`int`, *необязательный*, по умолчанию `2048`) : Размерность «промежуточного» (часто называемого feed-forward) слоя в декодере.
decoder_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
activation_function (`str`, *необязательный*, по умолчанию `relu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
d_model (`int`, *необязательный*, по умолчанию `256`) : Размер слоев кодировщика и пулера.
dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.1`) : Доля для всех слоёв dropout.
attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
activation_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для активаций внутри полносвязного слоя.
auxiliary_loss (`bool`, *необязательный*, по умолчанию `False`) : Использовать ли вспомогательные потери декодирования (потери на каждом слое декодера).
position_embedding_type (`str`, *необязательный*, по умолчанию `"sine"`) : Тип позиционных эмбеддингов, применяемых поверх признаков изображения. Одно из значений `"sine"` или `"learned"`.
num_feature_levels (`int`, *необязательный*, по умолчанию 4) : Количество уровней входных признаков.
encoder_n_points (`int`, *optional*, по умолчанию 4) : Количество выбранных ключей на каждом уровне признаков для каждой головы внимания в кодере.
decoder_n_points (`int`, *optional*, по умолчанию 4) : Количество выбранных ключей на каждом уровне признаков для каждой головы внимания в декодере.
two_stage (`bool`, *необязательный*, по умолчанию `True`) : Указывает, следует ли применять двухэтапный деформируемый DETR, в котором региональные предложения также генерируются вариантом Grounding DINO и далее передаются в декодер для итеративного уточнения ограничивающих прямоугольников.
class_cost (`float`, *необязательный*, по умолчанию `1.0`) : Относительный вес ошибки классификации в стоимости венгерского сопоставления.
bbox_cost (`float`, *необязательный*, по умолчанию `5.0`) : Относительный вес ошибки L1 для ограничивающих прямоугольников в стоимости венгерского сопоставления.
giou_cost (`float`, *optional*, по умолчанию `2.0`) : Относительный вес обобщённой функции потерь IoU в стоимости венгерского сопоставления.
bbox_loss_coefficient (`float`, *необязательный*, по умолчанию `5.0`) : Относительный вес потери L1 для ограничивающих прямоугольников в потере паноптической сегментации.
giou_loss_coefficient (`float`, *необязательный*, по умолчанию `2.0`) : Относительный вес обобщённой функции потерь IoU в функции потерь паноптической сегментации.
focal_alpha (`float`, *необязательный*, по умолчанию `0.25`) : Параметр alpha в функции потерь focal loss.
disable_custom_kernels (`bool`, *необязательный*, по умолчанию `False`) : Отключает использование собственных CUDA- и CPU-ядер. Эта опция необходима для экспорта в ONNX, так как собственные ядра не поддерживаются экспортом PyTorch в ONNX.
max_text_len (`int`, *необязательный*, по умолчанию 256) : Максимальная длина текстового ввода.
text_enhancer_dropout (`float`, *необязательный*, по умолчанию 0.0) : Коэффициент dropout для текстового усилителя.
fusion_droppath (`float`, *optional*, по умолчанию 0.1) : Коэффициент droppath для модуля слияния.
fusion_dropout (`float`, *необязательный*, по умолчанию 0.0) : Коэффициент dropout для модуля слияния.
embedding_init_target (`bool`, *необязательный*, по умолчанию `True`) : Инициализировать ли целевой объект весами Embedding.
query_dim (`int`, *optional*, по умолчанию 4) : Размерность вектора запроса.
decoder_bbox_embed_share (`bool`, *необязательный*, по умолчанию `True`) : Использовать ли общий заголовок регрессии bbox для всех слоев декодера.
two_stage_bbox_embed_share (`bool`, *необязательный*, по умолчанию `False`) : Нужно ли разделять bbox-эмбеддинг между двухэтапным генератором bbox и генерацией региональных предложений.
positional_embedding_temperature (`float`, *optional*, по умолчанию 20) : Температура для Sine Positional Embedding, используемая совместно с vision backbone.
init_std (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
tie_word_embeddings (`bool`, *необязательный*, по умолчанию `True`) : Связывать ли веса эмбеддингов согласно отображению `tied_weights_keys` модели.
Это класс конфигурации для хранения настроек модели Grounding Dino. Он используется для создания модели Grounding Dino в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации [IDEA-Research/grounding-dino-tiny](https://huggingface.co/IDEA-Research/grounding-dino-tiny)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/main/ru/main_classes/configuration#transformers.PreTrainedConfig).
Примеры:
```python
>>> from transformers import GroundingDinoConfig, GroundingDinoModel
>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()
>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GroundingDinoModel[[transformers.GroundingDinoModel]]
#### transformers.GroundingDinoModel[[transformers.GroundingDinoModel]]
```python
transformers.GroundingDinoModel(config: GroundingDinoConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L1866)
**Параметры:**
config ([GroundingDinoConfig](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Grounding DINO без дополнительных компонентов (состоящая из backbone и encoder-decoder Transformer), выводящая «сырые» hidden-states без какого-либо специализированного head сверху.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.GroundingDinoModel.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, token_type_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.Tensor] = None, encoder_outputs = None, output_attentions = None, output_hidden_states = None, return_dict = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2008)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [GroundingDinoImageProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Подробности см. в [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([GroundingDinoProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoProcessor) использует [GroundingDinoImageProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) для обработки изображений).
input_ids (`torch.LongTensor` формы `(batch_size, text_sequence_length)`) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется, если вы его предоставляете. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/main/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [BertTokenizer.__call__()](/docs/transformers/main/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__).
token_type_ids (`torch.LongTensor` формы `(batch_size, text_sequence_length)`, *необязательный*) : Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: 0 соответствует токену `sentence A`, 1 соответствует токену `sentence B` [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
pixel_mask (`torch.Tensor` формы `(batch_size, height, width)`, *необязательный*) : Маска для исключения пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
encoder_outputs (``) : Tuple consists of (`last_hidden_state`, *optional*: `hidden_states`, *optional*: `attentions`) `last_hidden_state` of shape `(batch_size, sequence_length, hidden_size)`, *optional*) — это последовательность скрытых состояний на выходе последнего слоя кодировщика. Используется в кросс-внимании декодера.
output_attentions (``) : Whether or not to return the attentions tensors of all attention layers. See `attentions` under returned tensors for more detail.
output_hidden_states (``) : Whether or not to return the hidden states of all layers. See `hidden_states` under returned tensors for more detail.
return_dict (``) : Возвращать ли [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
**Возвращает:** `GroundingDinoModelOutput` или `tuple(torch.Tensor)`
Объект `GroundingDinoModelOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([GroundingDinoConfig](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoConfig)) и входных данных.
Метод forward модели [GroundingDinoModel](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, num_queries, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя декодера модели.
- **init_reference_points** (`torch.Tensor` формы `(batch_size, num_queries, 4)`) -- Начальные опорные точки, передаваемые через декодер Transformer.
- **intermediate_hidden_states** (`torch.Tensor` формы `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Стек промежуточных скрытых состояний (выход каждого слоя декодера).
- **intermediate_reference_points** (`torch.Tensor` формы `(batch_size, config.decoder_layers, num_queries, 4)`) -- Стек промежуточных опорных точек (опорные точки каждого слоя декодера).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода эмбеддингов, если у модели есть слой эмбеддингов, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния декодера на выходе каждого слоя, а также выходные значения начального слоя встраивания.
- **decoder_attentions** (`tuple[tuple[torch.Tensor]]`, *необязательный*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания декодера после softmax внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
- **encoder_last_hidden_state_vision** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя энкодера модели.
- **encoder_last_hidden_state_text** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) -- Последовательность скрытых состояний на выходе последнего слоя энкодера модели.
- **encoder_vision_hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода визуальных эмбеддингов + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния визуального энкодера на выходе каждого слоя, а также начальные выводы эмбеддингов.
- **encoder_text_hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или при `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода текстовых эмбеддингов + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`. Скрытые состояния текстового энкодера на выходе каждого слоя, а также начальные выводы эмбеддингов.
- **encoder_attentions** (`tuple(tuple(torch.Tensor))`, *optional*, возвращается, если передано `output_attentions=True` или если `config.output_attentions=True`) -- Кортеж кортежей `torch.Tensor` (по одному для внимания каждого слоя) формы `(batch_size, num_heads, sequence_length, sequence_length)`. Веса внимания после softmax внимания, используемые для вычисления взвешенного среднего в заголовках внимания текст-зрение, зрение-текст, текст-усилитель (само-внимание) и многомасштабного деформируемого внимания. softmax внимания, используемый для вычисления взвешенного среднего в заголовках двунаправленного внимания.
- **enc_outputs_class** (`torch.Tensor` формы `(batch_size, sequence_length, config.num_labels)`, *необязательный*, возвращается, если `config.two_stage=True`) -- Оценки предсказанных ограничивающих прямоугольников, где верхние `config.num_queries` прямоугольников с наивысшими оценками выбираются в качестве региональных предложений на первом этапе. Выход бинарной классификации ограничивающих прямоугольников (т. е. передний план и фон).
- **enc_outputs_coord_logits** (`torch.Tensor` формы `(batch_size, sequence_length, 4)`, *необязательный*, возвращается, если `config.two_stage=True`) -- Логиты координат предсказанных ограничивающих прямоугольников на первом этапе.
- **encoder_logits** (`torch.Tensor` формы `(batch_size, sequence_length, config.num_labels)`, *необязательный*, возвращается, если `config.two_stage=True`) -- Логиты верхних `config.num_queries` ограничивающих прямоугольников с наивысшими оценками на первом этапе.
- **encoder_pred_boxes** (`torch.Tensor` формы `(batch_size, sequence_length, 4)`, *необязательный*, возвращается, если `config.two_stage=True`) -- Координаты верхних по оценке `config.num_queries` ограничивающих прямоугольников на первом этапе.
Примеры:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a cat."
>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
```
## GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
#### transformers.GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
```python
transformers.GroundingDinoForObjectDetection(config: GroundingDinoConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2376)
**Параметры:**
config ([GroundingDinoConfig](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Grounding DINO (состоящая из backbone и encoder-decoder Transformer) с головками для обнаружения объектов, предназначенная для таких задач, как обнаружение объектов COCO.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/main/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.GroundingDinoForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, token_type_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, pixel_mask: typing.Optional[torch.BoolTensor] = None, encoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, labels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2417)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [GroundingDinoImageProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Подробности см. в [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([GroundingDinoProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoProcessor) использует [GroundingDinoImageProcessor](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) для обработки изображений).
input_ids (`torch.LongTensor` формы `(batch_size, text_sequence_length)`) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется, если вы его предоставляете. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/main/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [BertTokenizer.__call__()](/docs/transformers/main/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__).
token_type_ids (`torch.LongTensor` формы `(batch_size, text_sequence_length)`, *необязательный*) : Индексы сегментных токенов для указания первой и второй частей входных данных. Индексы выбираются из `[0, 1]`: 0 соответствует токену `sentence A`, 1 соответствует токену `sentence B` [Что такое идентификаторы типов токенов?](../glossary#token-type-ids)
attention_mask (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
pixel_mask (`torch.BoolTensor` формы `(batch_size, height, width)`, *необязательный*) : Маска для исключения значений пикселей отступов из внимания. Значения маски выбираются из `[0, 1]`: - 1 для реальных пикселей (т. е. **не замаскированных**), - 0 для пикселей отступов (т. е. **замаскированных**). [Что такое маски внимания?](../glossary#attention-mask)
encoder_outputs (`Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple]`, *необязательный*) : Кортеж состоит из (`last_hidden_state`, *необязательный*: `hidden_states`, *необязательный*: `attentions`) `last_hidden_state` формы `(batch_size, sequence_length, hidden_size)`, *необязательный*) представляет собой последовательность скрытых состояний на выходе последнего слоя энкодера. Используется в кросс-внимании декодера.
output_attentions (`bool`, *необязательный*) : Нужно ли возвращать тензоры внимания всех слоев внимания. Подробнее см. `attentions` в разделе возвращаемых тензоров.
output_hidden_states (`bool`, *необязательный*) : Нужно ли возвращать скрытые состояния всех слоёв. Подробнее о `hidden_states` в разделе возвращаемых тензоров.
return_dict (`bool`, *необязательный*) : Нужно ли возвращать [ModelOutput](/docs/transformers/main/ru/main_classes/output#transformers.utils.ModelOutput) вместо обычного кортежа.
labels (`list[Dict]` длины `(batch_size,)`, *необязательный*) : Метки для вычисления функции потерь бипартитного сопоставления. Список словарей, каждый из которых содержит как минимум следующие два ключа: 'class_labels' и 'boxes' (соответственно, метки классов и ограничивающие рамки изображения в батче). Сами метки классов должны представлять собой `torch.LongTensor` длины `(number of bounding boxes in the image,)`, а рамки — `torch.Tensor` формы `(number of bounding boxes in the image, 4)`.
Метод forward класса [GroundingDinoForObjectDetection](/docs/transformers/main/ru/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
Примеры:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"
>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]
>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> results = processor.post_process_grounded_object_detection(
... outputs,
... threshold=0.4,
... text_threshold=0.3,
... target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
... box = [round(x, 2) for x in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]
```