# Grounding DINO
## Tổng quan
Mô hình Grounding DINO được đề xuất trong [Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection](https://huggingface.co/papers/2303.05499) của Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, Hao Zhang, Jie Yang, Chunyuan Li, Jianwei Yang, Hang Su, Jun Zhu, Lei Zhang. Grounding DINO mở rộng mô hình phát hiện đối tượng đóng bằng một bộ mã hóa văn bản, cho phép phát hiện đối tượng mở. Mô hình đạt được những kết quả đáng kể, chẳng hạn như 52.5 AP trên COCO zero-shot.
Tóm tắt từ bài báo như sau:
*Trong bài báo này, chúng tôi giới thiệu một bộ phát hiện đối tượng mở (open-set object detector) có tên là Grounding DINO, được xây dựng bằng cách kết hợp bộ phát hiện dựa trên Transformer DINO với huấn luyện trước có neo (grounded pre-training), cho phép phát hiện các đối tượng tùy ý dựa trên đầu vào của con người như tên danh mục hoặc các biểu thức tham chiếu. Giải pháp then chốt của phát hiện đối tượng mở là đưa ngôn ngữ vào một bộ phát hiện đóng (closed-set detector) để khái quát hóa khái niệm mở. Để tích hợp hiệu quả các phương thức ngôn ngữ và thị giác, về mặt khái niệm chúng tôi chia một bộ phát hiện đóng thành ba giai đoạn và đề xuất một giải pháp tích hợp chặt chẽ, bao gồm một bộ tăng cường đặc trưng, một cơ chế chọn truy vấn (query) có sự dẫn dắt của ngôn ngữ, và một bộ giải mã liên phương thức (cross-modality decoder) cho việc tích hợp liên phương thức. Trong khi các công trình trước đây chủ yếu đánh giá phát hiện đối tượng mở trên các danh mục mới (novel categories), chúng tôi đề xuất cũng thực hiện đánh giá trên việc hiểu biểu thức tham chiếu (referring expression comprehension) cho các đối tượng được chỉ định bằng thuộc tính. Grounding DINO hoạt động đặc biệt tốt trên cả ba cài đặt, bao gồm các bộ chuẩn (benchmark) trên COCO, LVIS, ODinW và RefCOCO/+/g. Grounding DINO đạt 52.5 AP trên bộ chuẩn chuyển giao zero-shot cho phát hiện COCO, tức là không sử dụng bất kỳ dữ liệu huấn luyện nào từ COCO. Nó thiết lập kỷ lục mới trên bộ chuẩn zero-shot ODinW với trung bình 26.1 AP.*
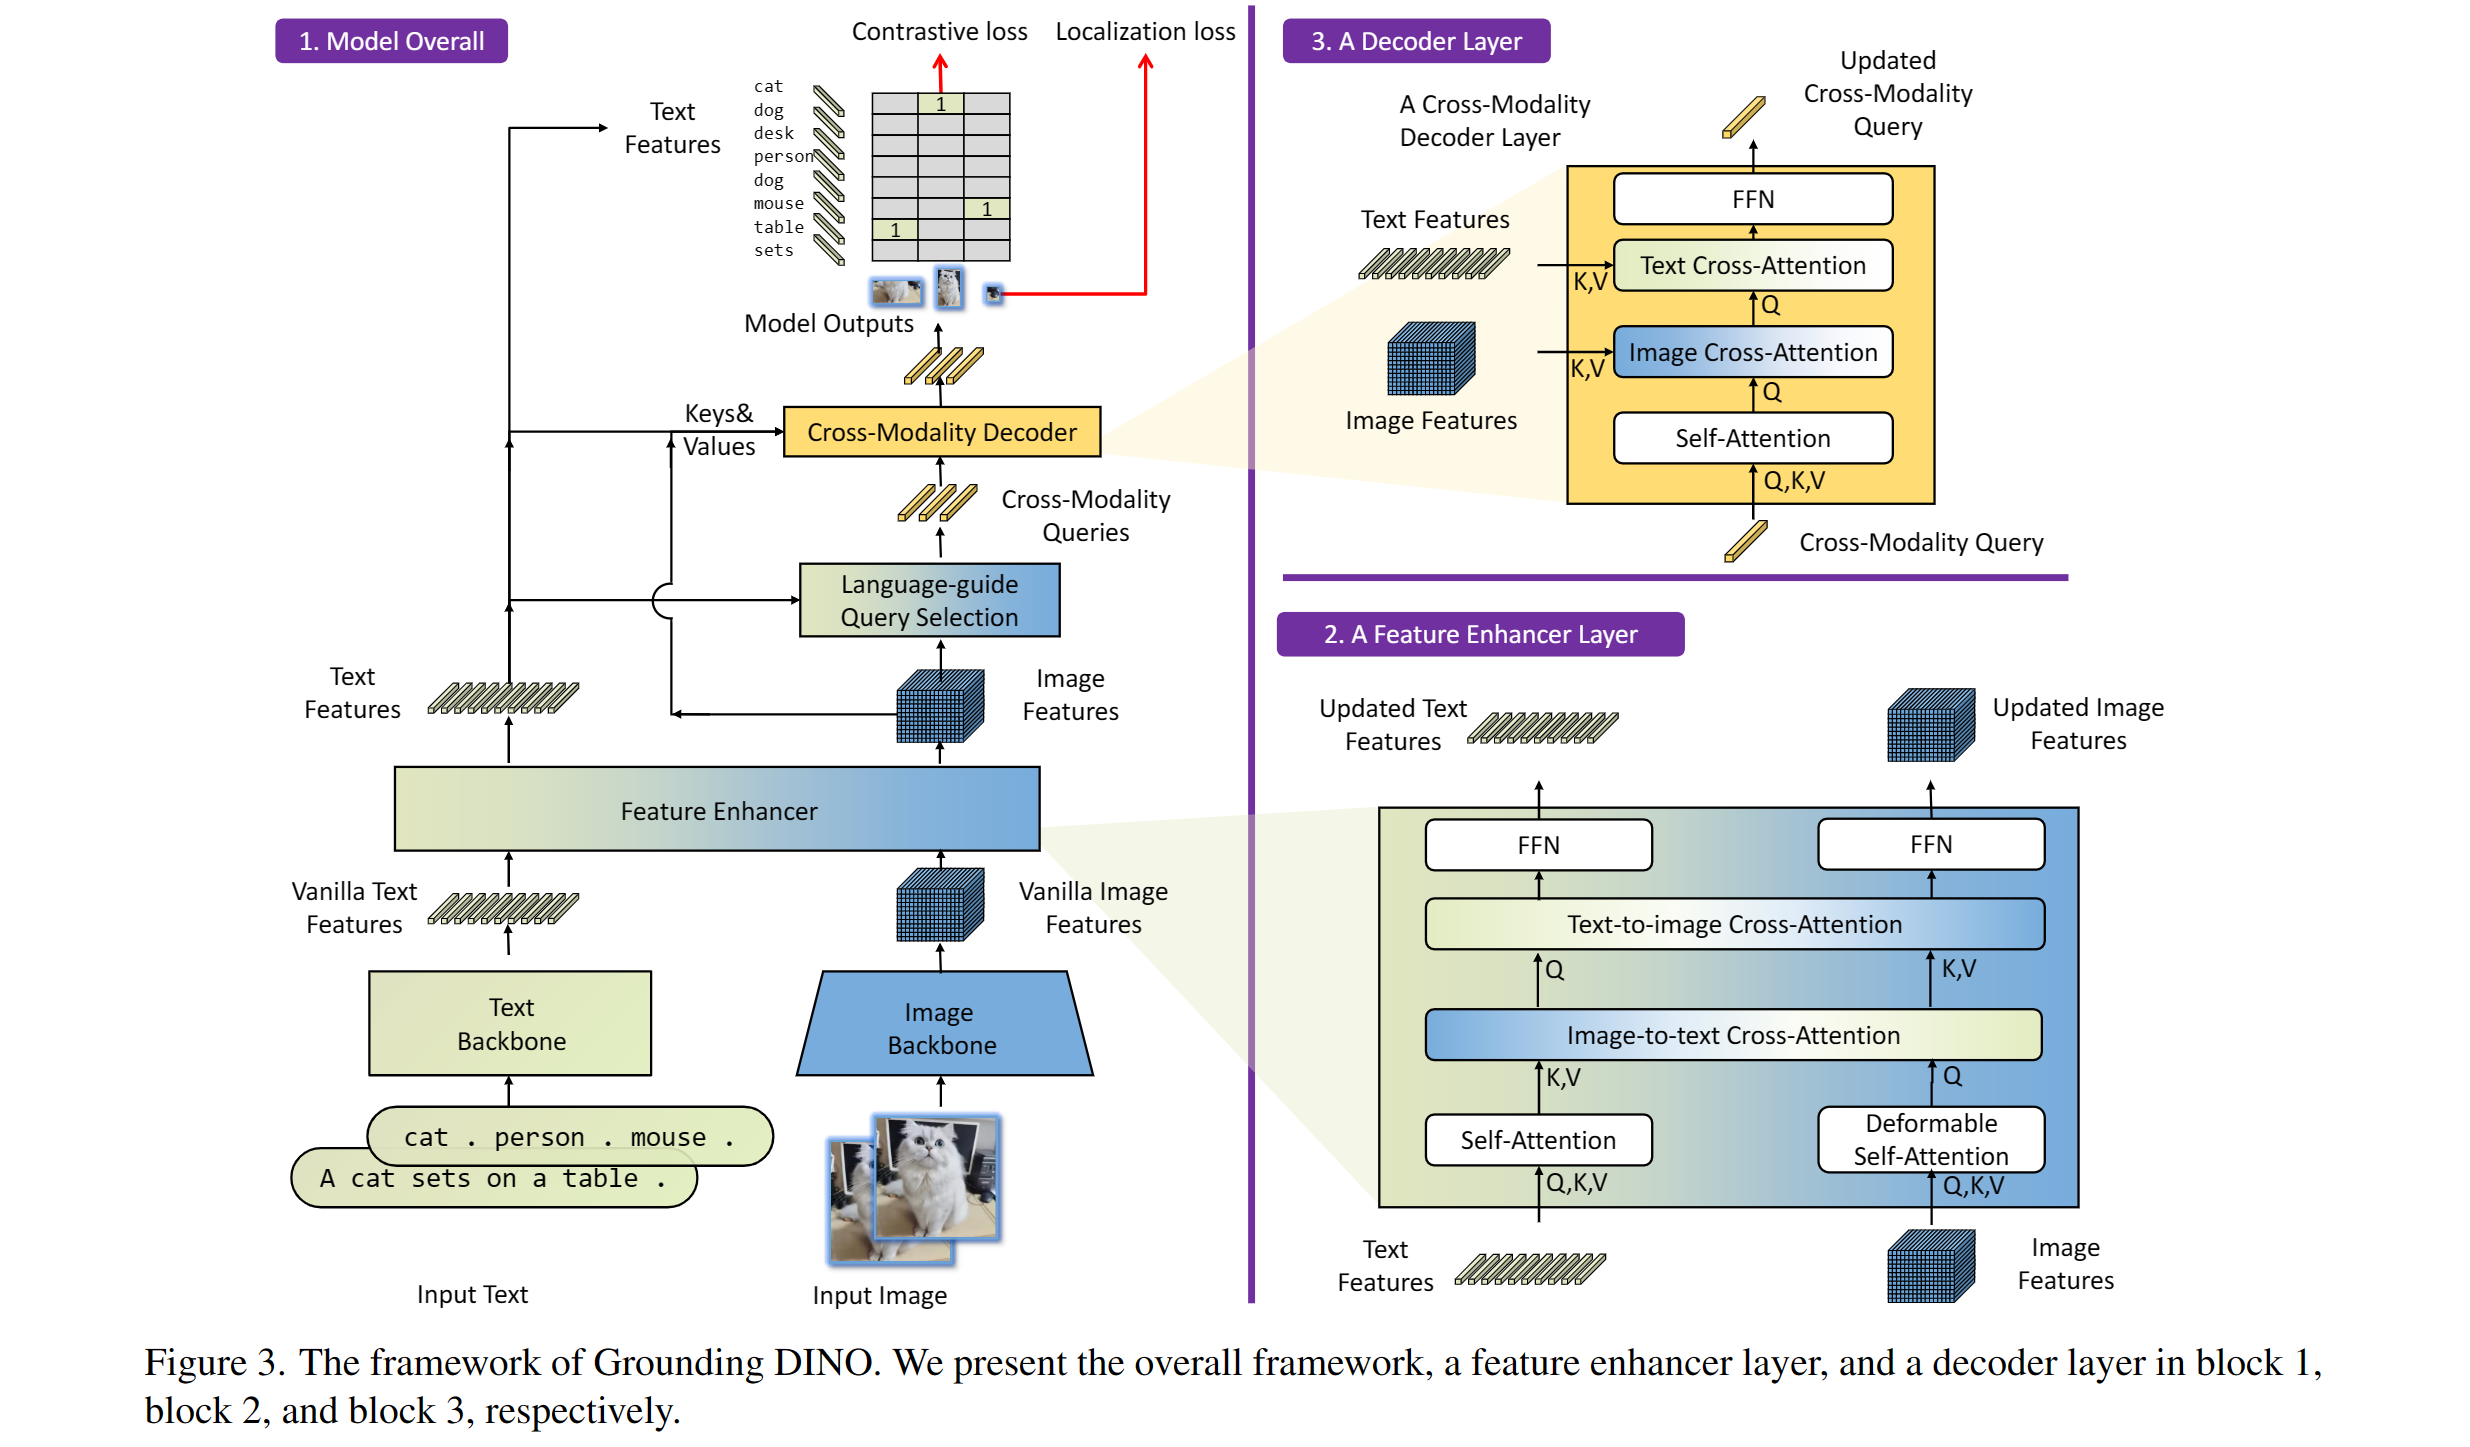 Tổng quan về Grounding DINO. Được trích từ bài báo gốc.
Mô hình này được đóng góp bởi [EduardoPacheco](https://huggingface.co/EduardoPacheco) và [nielsr](https://huggingface.co/nielsr). Mã gốc có thể được tìm thấy [tại đây](https://github.com/IDEA-Research/GroundingDINO).
## Mẹo sử dụng
- Bạn có thể sử dụng [GroundingDinoProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoProcessor) để chuẩn bị các cặp hình ảnh-văn bản cho mô hình.
- Để phân tách các lớp trong văn bản, hãy dùng dấu chấm, ví dụ: "a cat. a dog."
- Khi sử dụng nhiều lớp (ví dụ: `"a cat. a dog."`), hãy dùng `post_process_grounded_object_detection` từ [GroundingDinoProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoProcessor) để xử lý hậu kỳ các đầu ra. Vì các nhãn được trả về từ `post_process_object_detection` đại diện cho các chỉ số từ chiều của mô hình nơi prob > threshold.
Dưới đây là cách sử dụng mô hình cho phát hiện đối tượng zero-shot:
```python
import requests
import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")
image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]
inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
threshold=0.4,
text_threshold=0.3,
target_sizes=[image.size[::-1]]
)
# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
box = [round(x, 2) for x in box.tolist()]
print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
```
## Grounded SAM
Người dùng có thể kết hợp Grounding DINO với mô hình [Segment Anything](sam) để tạo mask dựa trên văn bản như đã giới thiệu trong [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159). Bạn có thể tham khảo [notebook demo](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) này 🌍 để biết thêm chi tiết.
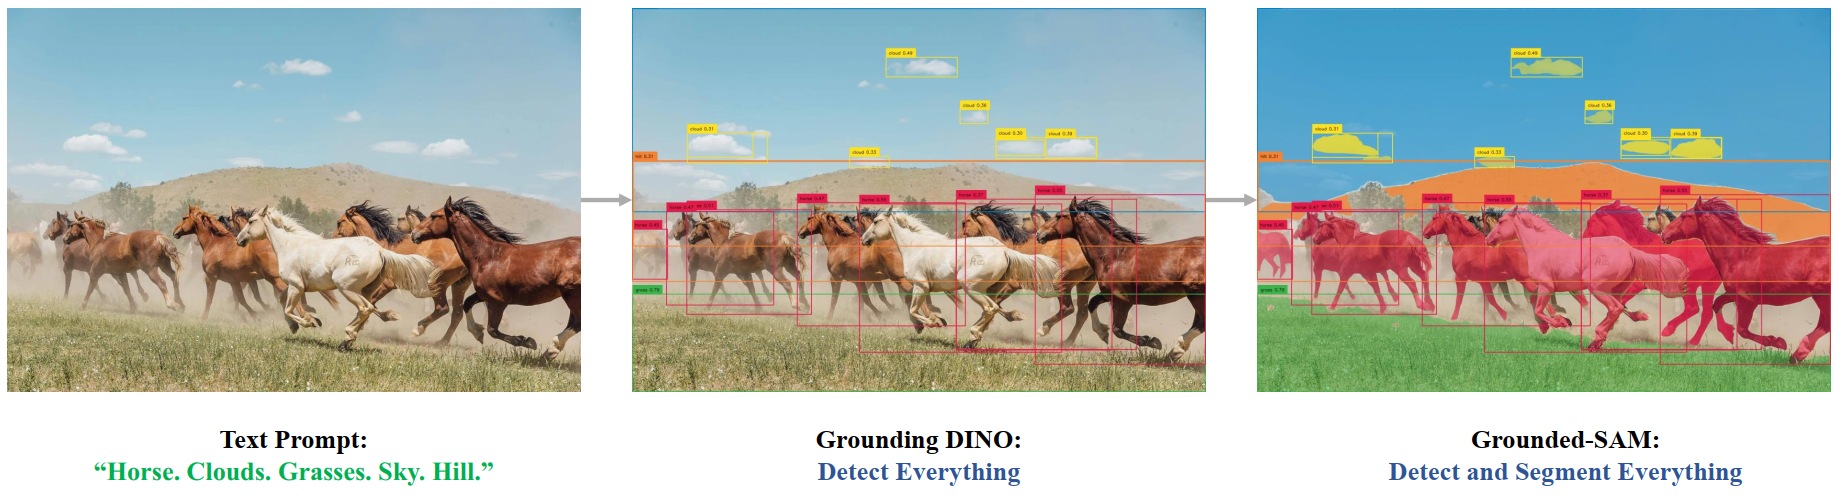 Tổng quan về Grounded SAM. Được trích từ kho lưu trữ gốc.
## Tài nguyên
Danh sách các tài nguyên chính thức của Hugging Face và cộng đồng (được đánh dấu bằng 🌎) để giúp bạn bắt đầu với Grounding DINO. Nếu bạn quan tâm đến việc gửi tài nguyên để được đưa vào đây, hãy thoải mái mở một Pull Request và chúng tôi sẽ xem xét! Tài nguyên lý tưởng nên minh họa điều gì đó mới thay vì sao chép một tài nguyên hiện có.
- Các notebook demo về suy luận với Grounding DINO cũng như kết hợp nó với [SAM](sam) có thể được tìm thấy [tại đây](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Grounding%20DINO). 🌎
## GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
#### transformers.GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
```python
transformers.GroundingDinoImageProcessor(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L308)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 800, 'longest_edge': 1333}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `2`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.485, 0.456, 0.406]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.229, 0.224, 0.225]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
format (`str`, *kwargs*, *tuỳ chọn*, mặc định là `AnnotationFormat.COCO_DETECTION`) : Định dạng dữ liệu của các chú thích. Một trong "coco_detection" hoặc "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, mặc định là `True`) : Kiểm soát việc có chuyển đổi các chú thích sang định dạng mà mô hình GROUNDING_DINO mong đợi hay không. Chuyển đổi các hộp bao quanh sang định dạng `(center_x, center_y, width, height)` và trong khoảng `[0, 1]`. Có thể ghi đè bằng tham số `do_convert_annotations` trong phương thức `preprocess`.
Tạo bộ xử lý ảnh GroundingDinoImageProcessor.
#### preprocess[[transformers.GroundingDinoImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L563)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
annotations (`AnnotationType` hoặc `list[AnnotationType]`, *tùy chọn*) : Các chú thích cần biến đổi theo cách đệm (padding) được áp dụng cho các hình ảnh.
return_segmentation_masks (`bool`, *tùy chọn*, mặc định là `self.return_segmentation_masks`) : Có trả về các mặt nạ phân đoạn hay không.
masks_path (`str` hoặc `pathlib.Path`, *tùy chọn*) : Đường dẫn đến thư mục chứa các mặt nạ phân đoạn.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
format (`str`, *kwargs*, *tuỳ chọn*, mặc định là `AnnotationFormat.COCO_DETECTION`) : Định dạng dữ liệu của các chú thích. Một trong "coco_detection" hoặc "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, mặc định là `True`) : Kiểm soát việc có chuyển đổi các chú thích sang định dạng mà mô hình GROUNDING_DINO mong đợi hay không. Chuyển đổi các hộp bao quanh sang định dạng `(center_x, center_y, width, height)` và trong khoảng `[0, 1]`. Có thể ghi đè bằng tham số `do_convert_annotations` trong phương thức `preprocess`.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
## GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
#### transformers.GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
```python
transformers.GroundingDinoImageProcessorPil(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L300)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'shortest_edge' : 800, 'longest_edge': 1333}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `2`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.485, 0.456, 0.406]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.229, 0.224, 0.225]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*, mặc định là `True`) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến kích thước vuông cố định cho từng ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
format (`str`, *kwargs*, *tuỳ chọn*, mặc định là `AnnotationFormat.COCO_DETECTION`) : Định dạng dữ liệu của các chú thích. Một trong "coco_detection" hoặc "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, mặc định là `True`) : Kiểm soát việc có chuyển đổi các chú thích sang định dạng mà mô hình GROUNDING_DINO mong đợi hay không. Chuyển đổi các hộp bao quanh sang định dạng `(center_x, center_y, width, height)` và trong khoảng `[0, 1]`. Có thể ghi đè bằng tham số `do_convert_annotations` trong phương thức `preprocess`.
Tạo bộ xử lý ảnh GroundingDinoImageProcessor.
#### preprocess[[transformers.GroundingDinoImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L568)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
annotations (`AnnotationType` hoặc `list[AnnotationType]`, *tùy chọn*) : Các chú thích cần biến đổi theo cách đệm (padding) được áp dụng cho các hình ảnh.
return_segmentation_masks (`bool`, *tùy chọn*, mặc định là `self.return_segmentation_masks`) : Có trả về các mặt nạ phân đoạn hay không.
masks_path (`str` hoặc `pathlib.Path`, *tùy chọn*) : Đường dẫn đến thư mục chứa các mặt nạ phân đoạn.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
format (`str`, *kwargs*, *tuỳ chọn*, mặc định là `AnnotationFormat.COCO_DETECTION`) : Định dạng dữ liệu của các chú thích. Một trong "coco_detection" hoặc "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *optional*, mặc định là `True`) : Kiểm soát việc có chuyển đổi các chú thích sang định dạng mà mô hình GROUNDING_DINO mong đợi hay không. Chuyển đổi các hộp bao quanh sang định dạng `(center_x, center_y, width, height)` và trong khoảng `[0, 1]`. Có thể ghi đè bằng tham số `do_convert_annotations` trong phương thức `preprocess`.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
#### post_process_object_detection[[transformers.GroundingDinoImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: GroundingDinoObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L713)
**Tham số:**
outputs (`GroundingDinoObjectDetectionOutput`) : Đầu ra thô của mô hình.
threshold (`float`, *tuỳ chọn*, mặc định là 0.1) : Ngưỡng điểm để giữ lại các dự đoán phát hiện đối tượng.
target_sizes (`torch.Tensor` hoặc `list[tuple[int, int]]`, *tùy chọn*) : Tensor có shape `(batch_size, 2)` hoặc danh sách các tuple (`tuple[int, int]`) chứa kích thước đích `(height, width)` của mỗi hình ảnh trong batch. Nếu không được đặt, các dự đoán sẽ không được thay đổi kích thước.
**Trả về:** `list[Dict]`
Một danh sách các từ điển, mỗi từ điển chứa các khóa sau:
- "scores": Điểm tin cậy cho mỗi hộp dự đoán trên hình ảnh.
- "labels": Chỉ số của các lớp do mô hình dự đoán trên hình ảnh.
- "boxes": Hộp bao quanh hình ảnh theo định dạng (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Chuyển đổi đầu ra thô của [GroundingDinoForObjectDetection](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) thành các hộp bao cuối cùng ở định dạng (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
## GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
#### transformers.GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
```python
transformers.GroundingDinoProcessor(image_processor, tokenizer)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L115)
**Tham số:**
image_processor (`GroundingDinoImageProcessor`) : Bộ xử lý ảnh là một đầu vào bắt buộc.
tokenizer (`BertTokenizer`) : Tokenizer là một đầu vào bắt buộc.
Tạo một GroundingDinoProcessor đóng gói một bộ xử lý ảnh và một tokenizer thành một bộ xử lý duy nhất.
[GroundingDinoProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoProcessor) cung cấp đầy đủ các chức năng của [GroundingDinoImageProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) và [BertTokenizer](/docs/transformers/main/vi/model_doc/lxmert#transformers.BertTokenizer). Xem [~GroundingDinoImageProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) và [~BertTokenizer](/docs/transformers/main/vi/model_doc/lxmert#transformers.BertTokenizer) để biết thêm thông tin.
#### __call__[[transformers.GroundingDinoProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L653)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *tùy chọn*) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh với giá trị pixel dao động từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel nằm trong khoảng từ 0 đến 1, hãy đặt `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *tùy chọn*) : Chuỗi hoặc lô các chuỗi cần được mã hóa. Mỗi chuỗi có thể là một chuỗi ký tự hoặc một danh sách các chuỗi ký tự (chuỗi đã được tách token trước). Nếu bạn truyền vào đầu vào đã tách token trước, hãy đặt `is_split_into_words=True` để tránh nhầm lẫn với các đầu vào dạng lô.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *optional*) : Video cần tiền xử lý. Kỳ vọng một video đơn hoặc một batch video với giá trị pixel từ 0 đến 255. Nếu truyền vào video có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *optional*) : Âm thanh hoặc lô âm thanh cần được chuẩn bị. Mỗi âm thanh có thể là mảng NumPy hoặc tensor PyTorch. Trong trường hợp là mảng NumPy/tensor PyTorch, mỗi âm thanh nên có hình dạng (C, T), trong đó C là số kênh và T là độ dài mẫu của âm thanh.
return_tensors (`str` hoặc [TensorType](/docs/transformers/main/vi/internal/file_utils#transformers.TensorType), *optional*) : Nếu được đặt, sẽ trả về các tensor của một framework cụ thể. Các giá trị chấp nhận được là: - `'pt'`: Trả về các đối tượng `torch.Tensor` của PyTorch. - `'np'`: Trả về các đối tượng `np.ndarray` của NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/vi/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Các tùy chọn xử lý bổ sung cho từng phương thức (text, images, videos, audio). Các tham số cụ thể của model được liệt kê ở trên; xem lớp TypedDict để biết danh sách đầy đủ các đối số được hỗ trợ.
#### post_process_grounded_object_detection[[transformers.GroundingDinoProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: GroundingDinoObjectDetectionOutput, input_ids: transformers.utils.generic.TensorType | None = None, threshold: float = 0.25, text_threshold: float = 0.25, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/processing_grounding_dino.py#L143)
**Tham số:**
outputs (`GroundingDinoObjectDetectionOutput`) : Đầu ra thô của mô hình.
input_ids (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Các id token của văn bản đầu vào. Nếu không được cung cấp, chúng sẽ được lấy từ đầu ra của mô hình.
threshold (`float`, *optional*, mặc định là 0.25) : Ngưỡng để giữ lại các dự đoán phát hiện đối tượng dựa trên điểm tin cậy.
text_threshold (`float`, *optional*, mặc định là 0.25) : Ngưỡng điểm để giữ lại các dự đoán phát hiện văn bản.
target_sizes (`torch.Tensor` hoặc `list[tuple[int, int]]`, *tùy chọn*) : Tensor có shape `(batch_size, 2)` hoặc danh sách các tuple (`tuple[int, int]`) chứa kích thước đích `(height, width)` của mỗi hình ảnh trong batch. Nếu không được đặt, các dự đoán sẽ không được thay đổi kích thước.
text_labels (`list[list[str]]`, *tùy chọn*) : Danh sách các nhãn ứng viên cần được phát hiện trên mỗi hình ảnh. Hiện tại, tham số này *CHƯA được sử dụng*, nhưng vẫn bắt buộc phải có trong chữ ký của pipeline phát hiện đối tượng zero-shot. Các nhãn văn bản thay vào đó được trích xuất từ tensor `input_ids` được cung cấp trong `outputs`.
**Trả về:** `list[Dict]`
Một danh sách các từ điển, mỗi từ điển chứa
- **scores**: tensor chứa điểm tin cậy cho các đối tượng được phát hiện
- **boxes**: tensor chứa các hộp bao quanh theo định dạng [x0, y0, x1, y1]
- **labels**: danh sách nhãn văn bản cho từng đối tượng được phát hiện (sẽ được thay thế bằng các id số nguyên trong v4.51.0)
- **text_labels**: danh sách nhãn văn bản cho các đối tượng được phát hiện
Chuyển đổi đầu ra thô của [GroundingDinoForObjectDetection](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) thành các hộp bao cuối cùng ở định dạng (top_left_x, top_left_y, bottom_right_x, bottom_right_y) và lấy nhãn văn bản liên quan.
## GroundingDinoConfig[[transformers.GroundingDinoConfig]]
#### transformers.GroundingDinoConfig[[transformers.GroundingDinoConfig]]
```python
transformers.GroundingDinoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_queries: int = 900, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = True, class_cost: float = 1.0, bbox_cost: float = 5.0, giou_cost: float = 2.0, bbox_loss_coefficient: float = 5.0, giou_loss_coefficient: float = 2.0, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, max_text_len: int = 256, text_enhancer_dropout: float | int = 0.0, fusion_droppath: float | int = 0.1, fusion_dropout: float | int = 0.0, embedding_init_target: bool = True, query_dim: int = 4, decoder_bbox_embed_share: bool = True, two_stage_bbox_embed_share: bool = False, positional_embedding_temperature: int = 20, init_std: float = 0.02, layer_norm_eps: float = 1e-05, tie_word_embeddings: bool = True)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/configuration_grounding_dino.py#L28)
**Tham số:**
is_encoder_decoder (`bool`, *tùy chọn*, mặc định là `True`) : Xác định xem mô hình có được sử dụng như một bộ mã hóa/giải mã hay không.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Cấu hình của mô hình backbone.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *tùy chọn*) : Đối tượng config hoặc từ điển của text backbone.
num_queries (`int`, *tuỳ chọn*, mặc định là 900) : Số lượng truy vấn đối tượng, tức là các khe phát hiện. Đây là số lượng đối tượng tối đa mà [GroundingDinoModel](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoModel) có thể phát hiện trong một hình ảnh duy nhất.
encoder_layers (`int`, *tuỳ chọn*, mặc định là `6`) : Số lượng lớp ẩn trong bộ mã hóa Transformer. Sẽ sử dụng cùng giá trị với `num_layers` nếu không được đặt.
encoder_ffn_dim (`int`, *optional*, mặc định là `2048`) : Chiều của lớp "intermediate" (thường được gọi là feed-forward) trong encoder.
encoder_attention_heads (`int`, *tuỳ chọn*, mặc định là `8`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ mã hóa Transformer.
decoder_layers (`int`, *tuỳ chọn*, mặc định là `6`) : Số lượng lớp ẩn trong bộ giải mã Transformer. Nếu không được đặt, giá trị này sẽ giống với `num_layers`.
decoder_ffn_dim (`int`, *tuỳ chọn*, mặc định là `2048`) : Độ lớn chiều của lớp "trung gian" (thường được gọi là lớp feed-forward) trong bộ giải mã.
decoder_attention_heads (`int`, *tuỳ chọn*, mặc định là `8`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
activation_function (`str`, *tùy chọn*, mặc định là `relu`) : Hàm kích hoạt phi tuyến tính (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
d_model (`int`, *tuỳ chọn*, mặc định là `256`) : Kích thước của các lớp encoder và lớp pooler.
dropout (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Tỷ lệ cho tất cả các lớp dropout.
attention_dropout (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
activation_dropout (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các kích hoạt bên trong lớp liên kết đầy đủ.
auxiliary_loss (`bool`, *tùy chọn*, mặc định là `False`) : Xác định có sử dụng các tổn thất giải mã phụ (tổn thất ở mỗi lớp giải mã) hay không.
position_embedding_type (`str`, *tùy chọn*, mặc định là `"sine"`) : Loại position embeddings được sử dụng trên các đặc trưng hình ảnh. Một trong `"sine"` hoặc `"learned"`.
num_feature_levels (`int`, *tuỳ chọn*, mặc định là 4) : Số lượng cấp độ đặc trưng đầu vào.
encoder_n_points (`int`, *tuỳ chọn*, mặc định là 4) : Số lượng các key được lấy mẫu ở mỗi cấp độ đặc trưng cho mỗi đầu chú ý trong bộ mã hóa.
decoder_n_points (`int`, *tuỳ chọn*, mặc định là 4) : Số lượng các key được lấy mẫu ở mỗi cấp độ đặc trưng cho mỗi đầu chú ý trong bộ giải mã.
two_stage (`bool`, *tùy chọn*, mặc định là `True`) : Xác định có áp dụng DETR biến dạng hai giai đoạn hay không, trong đó các đề xuất vùng cũng được tạo ra bởi một biến thể của Grounding DINO, sau đó được đưa vào bộ giải mã để tinh chỉnh hộp bao quanh một cách lặp lại.
class_cost (`float`, *tuỳ chọn*, mặc định là `1.0`) : Trọng số tương đối của lỗi phân loại trong chi phí khớp Hungarian.
bbox_cost (`float`, *optional*, mặc định là `5.0`) : Trọng số tương đối của lỗi hộp bao L1 trong chi phí khớp Hungarian.
giou_cost (`float`, *tuỳ chọn*, mặc định là `2.0`) : Trọng số tương đối của tổn thất IoU tổng quát trong chi phí khớp Hungarian.
bbox_loss_coefficient (`float`, *tuỳ chọn*, mặc định là `5.0`) : Trọng số tương đối của tổn thất hộp bao L1 trong tổn thất phân đoạn toàn cảnh.
giou_loss_coefficient (`float`, *tuỳ chọn*, mặc định là `2.0`) : Trọng số tương đối của tổn thất IoU tổng quát trong tổn thất phân đoạn panoptic.
focal_alpha (`float`, *tuỳ chọn*, mặc định là `0.25`) : Tham số Alpha trong focal loss.
disable_custom_kernels (`bool`, *tùy chọn*, mặc định là `False`) : Vô hiệu hóa việc sử dụng các kernel CUDA và CPU tùy chỉnh. Tùy chọn này là cần thiết cho việc xuất ONNX, vì các kernel tùy chỉnh không được hỗ trợ bởi PyTorch ONNX export.
max_text_len (`int`, *tuỳ chọn*, mặc định là 256) : Độ dài tối đa của đầu vào văn bản.
text_enhancer_dropout (`float`, *tuỳ chọn*, mặc định là 0.0) : Tỷ lệ dropout cho bộ tăng cường văn bản.
fusion_droppath (`float`, *optional*, mặc định là 0.1) : Tỷ lệ droppath cho module fusion.
fusion_dropout (`float`, *tuỳ chọn*, mặc định là 0.0) : Tỷ lệ dropout cho module fusion.
embedding_init_target (`bool`, *tùy chọn*, mặc định là `True`) : Xác định có khởi tạo target với trọng số Embedding hay không.
query_dim (`int`, *optional*, mặc định là 4) : Kích thước của vector truy vấn.
decoder_bbox_embed_share (`bool`, *tùy chọn*, mặc định là `True`) : Có chia sẻ đầu hồi quy bbox cho tất cả các lớp giải mã hay không.
two_stage_bbox_embed_share (`bool`, *tuỳ chọn*, mặc định là `False`) : Có chia sẻ nhúng bbox giữa bộ tạo bbox hai giai đoạn và việc tạo đề xuất vùng hay không.
positional_embedding_temperature (`float`, *tuỳ chọn*, mặc định là 20) : Nhiệt độ cho Sine Positional Embedding được sử dụng cùng với vision backbone.
init_std (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-05`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
tie_word_embeddings (`bool`, *tùy chọn*, mặc định là `True`) : Có nên gắn kết các nhúng trọng số theo ánh xạ `tied_weights_keys` của mô hình hay không.
Đây là lớp cấu hình để lưu trữ cấu hình của một mô hình Grounding Dino. Nó được sử dụng để khởi tạo một mô hình Grounding Dino theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [IDEA-Research/grounding-dino-tiny](https://huggingface.co/IDEA-Research/grounding-dino-tiny)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import GroundingDinoConfig, GroundingDinoModel
>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()
>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GroundingDinoModel[[transformers.GroundingDinoModel]]
#### transformers.GroundingDinoModel[[transformers.GroundingDinoModel]]
```python
transformers.GroundingDinoModel(config: GroundingDinoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L1866)
**Tham số:**
config ([GroundingDinoConfig](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình Grounding DINO cơ bản (gồm một backbone và Transformer encoder-decoder) xuất ra các hidden-state thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.GroundingDinoModel.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, token_type_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.Tensor] = None, encoder_outputs = None, output_attentions = None, output_hidden_states = None, return_dict = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2008)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [GroundingDinoImageProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Xem [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([GroundingDinoProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoProcessor) sử dụng [GroundingDinoImageProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) để xử lý ảnh).
input_ids (`torch.LongTensor` có shape `(batch_size, text_sequence_length)`) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Padding sẽ bị bỏ qua mặc định nếu bạn cung cấp. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [BertTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết.
token_type_ids (`torch.LongTensor` có hình dạng `(batch_size, text_sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: 0 tương ứng với token `sentence A`, 1 tương ứng với token `sentence B` [Token type IDs là gì?](../glossary#token-type-ids)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
pixel_mask (`torch.Tensor` có hình dạng `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
encoder_outputs (``) : Tuple consists of (`last_hidden_state`, *optional*: `hidden_states`, *optional*: `attentions`) `last_hidden_state` of shape `(batch_size, sequence_length, hidden_size)`, *optional*) is a sequence of hidden-states at the output of the last layer of the encoder. Used in the cross-attention of the decoder.
output_attentions (``) : Whether or not to return the attentions tensors of all attention layers. See `attentions` under returned tensors for more detail.
output_hidden_states (``) : Whether or not to return the hidden states of all layers. See `hidden_states` under returned tensors for more detail.
return_dict (``) : Có nên trả về một [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
**Trả về:** `GroundingDinoModelOutput` hoặc `tuple(torch.Tensor)`
Một `GroundingDinoModelOutput` hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([GroundingDinoConfig](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoConfig)) và đầu vào.
Phương thức forward của [GroundingDinoModel](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, num_queries, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của bộ giải mã (decoder) của mô hình.
- **init_reference_points** (`torch.Tensor` có hình dạng `(batch_size, num_queries, 4)`) -- Các điểm tham chiếu ban đầu được truyền qua bộ giải mã Transformer.
- **intermediate_hidden_states** (`torch.Tensor` có hình dạng `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Các trạng thái ẩn trung gian được xếp chồng (đầu ra của từng lớp trong bộ giải mã).
- **intermediate_reference_points** (`torch.Tensor` có hình dạng `(batch_size, config.decoder_layers, num_queries, 4)`) -- Các điểm tham chiếu trung gian được xếp chồng (điểm tham chiếu của từng lớp trong bộ giải mã).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple các `torch.Tensor` (một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của bộ giải mã tại đầu ra của mỗi lớp cùng với đầu ra của nhúng ban đầu.
- **decoder_attentions** (`tuple[tuple[torch.Tensor]]`, *tùy chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý của bộ giải mã, sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý tự (self-attention).
- **encoder_last_hidden_state_vision** (`torch.Tensor` có shape `(batch_size, sequence_length, hidden_size)`, *optional*) -- Chuỗi hidden-states tại đầu ra của lớp cuối cùng của encoder trong model.
- **encoder_last_hidden_state_text** (`torch.Tensor` có shape `(batch_size, sequence_length, hidden_size)`, *optional*) -- Chuỗi hidden-states tại đầu ra của lớp cuối cùng của encoder trong model.
- **encoder_vision_hidden_states** (`tuple(torch.Tensor)`, *tùy chọn*, được trả về khi truyền `output_hidden_states=True` hoặc khi `config.output_hidden_states=True`) -- Tuple của `torch.Tensor` (một cho đầu ra của vision embeddings + một cho đầu ra của mỗi lớp) có shape `(batch_size, sequence_length, hidden_size)`. Hidden-states của vision encoder tại đầu ra của mỗi lớp cùng với đầu ra của embedding ban đầu.
- **encoder_text_hidden_states** (`tuple(torch.Tensor)`, *tùy chọn*, được trả về khi truyền `output_hidden_states=True` hoặc khi `config.output_hidden_states=True`) -- Tuple của `torch.Tensor` (một cho đầu ra của text embeddings + một cho đầu ra của mỗi lớp) có shape `(batch_size, sequence_length, hidden_size)`. Hidden-states của text encoder tại đầu ra của mỗi lớp cùng với đầu ra embedding ban đầu.
- **encoder_attentions** (`tuple(tuple(torch.Tensor))`, *optional*, được trả về khi truyền `output_attentions=True` hoặc khi `config.output_attentions=True`) -- Tuple của các tuple `torch.Tensor` (một cho attention của mỗi lớp) có shape `(batch_size, num_heads, sequence_length, sequence_length)`. Trọng số attention sau softmax attention, được dùng để tính trung bình có trọng số trong các đầu attention text-vision, vision-text, text-enhancer (self-attention) và multi-scale deformable attention. attention softmax, được dùng để tính trung bình có trọng số trong các đầu bi-attention.
- **enc_outputs_class** (`torch.Tensor` có shape `(batch_size, sequence_length, config.num_labels)`, *optional*, được trả về khi `config.two_stage=True`) -- Điểm số dự đoán của các bounding box, trong đó `config.num_queries` bounding box có điểm cao nhất được chọn làm region proposals ở giai đoạn đầu. Đây là đầu ra của phân loại nhị phân bounding box (tức là foreground và background).
- **enc_outputs_coord_logits** (`torch.Tensor` có shape `(batch_size, sequence_length, 4)`, *optional*, được trả về khi `config.two_stage=True`) -- Logits của tọa độ bounding box dự đoán ở giai đoạn đầu tiên.
- **encoder_logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.num_labels)`, *tùy chọn*, được trả về khi `config.two_stage=True`) -- Logits của `config.num_queries` bounding box có điểm đánh giá cao nhất ở giai đoạn đầu.
- **encoder_pred_boxes** (`torch.Tensor` có shape `(batch_size, sequence_length, 4)`, *optional*, được trả về khi `config.two_stage=True`) -- Tọa độ của `config.num_queries` bounding box có điểm số cao nhất ở giai đoạn đầu.
Ví dụ:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a cat."
>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
```
## GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
#### transformers.GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
```python
transformers.GroundingDinoForObjectDetection(config: GroundingDinoConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2376)
**Tham số:**
config ([GroundingDinoConfig](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình Grounding DINO (gồm một backbone và Transformer encoder-decoder) với các đầu dò phát hiện đối tượng phía trên, dành cho các tác vụ như phát hiện COCO.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.GroundingDinoForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, token_type_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, pixel_mask: typing.Optional[torch.BoolTensor] = None, encoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, labels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2417)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [GroundingDinoImageProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor). Xem [GroundingDinoImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết ([GroundingDinoProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoProcessor) sử dụng [GroundingDinoImageProcessor](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) để xử lý ảnh).
input_ids (`torch.LongTensor` có shape `(batch_size, text_sequence_length)`) : Chỉ số của các token trong chuỗi đầu vào theo từ vựng. Padding sẽ bị bỏ qua mặc định nếu bạn cung cấp. Có thể lấy chỉ số bằng cách sử dụng [AutoTokenizer](/docs/transformers/main/vi/model_doc/auto#transformers.AutoTokenizer). Xem [BertTokenizer.__call__()](/docs/transformers/main/vi/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) để biết chi tiết.
token_type_ids (`torch.LongTensor` có hình dạng `(batch_size, text_sequence_length)`, *tùy chọn*) : Các chỉ số token phân đoạn để chỉ định phần đầu và phần thứ hai của các đầu vào. Các chỉ số được chọn trong `[0, 1]`: 0 tương ứng với token `sentence A`, 1 tương ứng với token `sentence B` [Token type IDs là gì?](../glossary#token-type-ids)
attention_mask (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
pixel_mask (`torch.BoolTensor` có shape `(batch_size, height, width)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các giá trị pixel đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các pixel thực (tức là **không bị che**), - 0 cho các pixel đệm (tức là **bị che**). [Mặt nạ chú ý là gì?](../glossary#attention-mask)
encoder_outputs (`Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple]`, *tuỳ chọn*) : Tuple gồm (`last_hidden_state`, *tuỳ chọn*: `hidden_states`, *tuỳ chọn*: `attentions`) `last_hidden_state` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tuỳ chọn*) là một chuỗi các hidden-states tại đầu ra của lớp cuối cùng của encoder. Được sử dụng trong cross-attention của decoder.
output_attentions (`bool`, *tùy chọn*) : Có trả về các tensor chú ý của tất cả các lớp chú ý hay không. Xem `attentions` trong phần tensor trả về để biết thêm chi tiết.
output_hidden_states (`bool`, *tuỳ chọn*) : Có trả về trạng thái ẩn của tất cả các lớp hay không. Xem `hidden_states` trong phần tensor trả về để biết thêm chi tiết.
return_dict (`bool`, *tùy chọn*) : Có trả về [ModelOutput](/docs/transformers/main/vi/main_classes/output#transformers.utils.ModelOutput) thay vì một tuple thông thường hay không.
labels (`list[Dict]` có độ dài `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất khớp hai phần. Danh sách các từ điển, mỗi từ điển chứa ít nhất 2 khóa sau: 'class_labels' và 'boxes' (lần lượt là nhãn lớp và hộp bao quanh của một hình ảnh trong lô). Bản thân các nhãn lớp phải là một `torch.LongTensor` có độ dài `(number of bounding boxes in the image,)` và các hộp bao quanh phải là một `torch.Tensor` có hình dạng `(number of bounding boxes in the image, 4)`.
Phương thức forward của [GroundingDinoForObjectDetection](/docs/transformers/main/vi/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
Ví dụ:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"
>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]
>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> results = processor.post_process_grounded_object_detection(
... outputs,
... threshold=0.4,
... text_threshold=0.3,
... target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
... box = [round(x, 2) for x in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]
```