# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377) là một mô hình thị giác tự giám sát được huấn luyện trước bằng cách che đi phần lớn hình ảnh (~75%). Một bộ mã hóa xử lý các mảnh hình ảnh hiển thị và một bộ giải mã tái tạo các pixel bị thiếu từ các mảnh đã được mã hóa và các token mặt nạ. Sau khi huấn luyện trước, bộ mã hóa có thể được tái sử dụng cho các tác vụ hạ nguồn như phân loại hình ảnh hoặc phát hiện đối tượng — thường vượt trội hơn so với các mô hình được huấn luyện bằng học có giám sát.
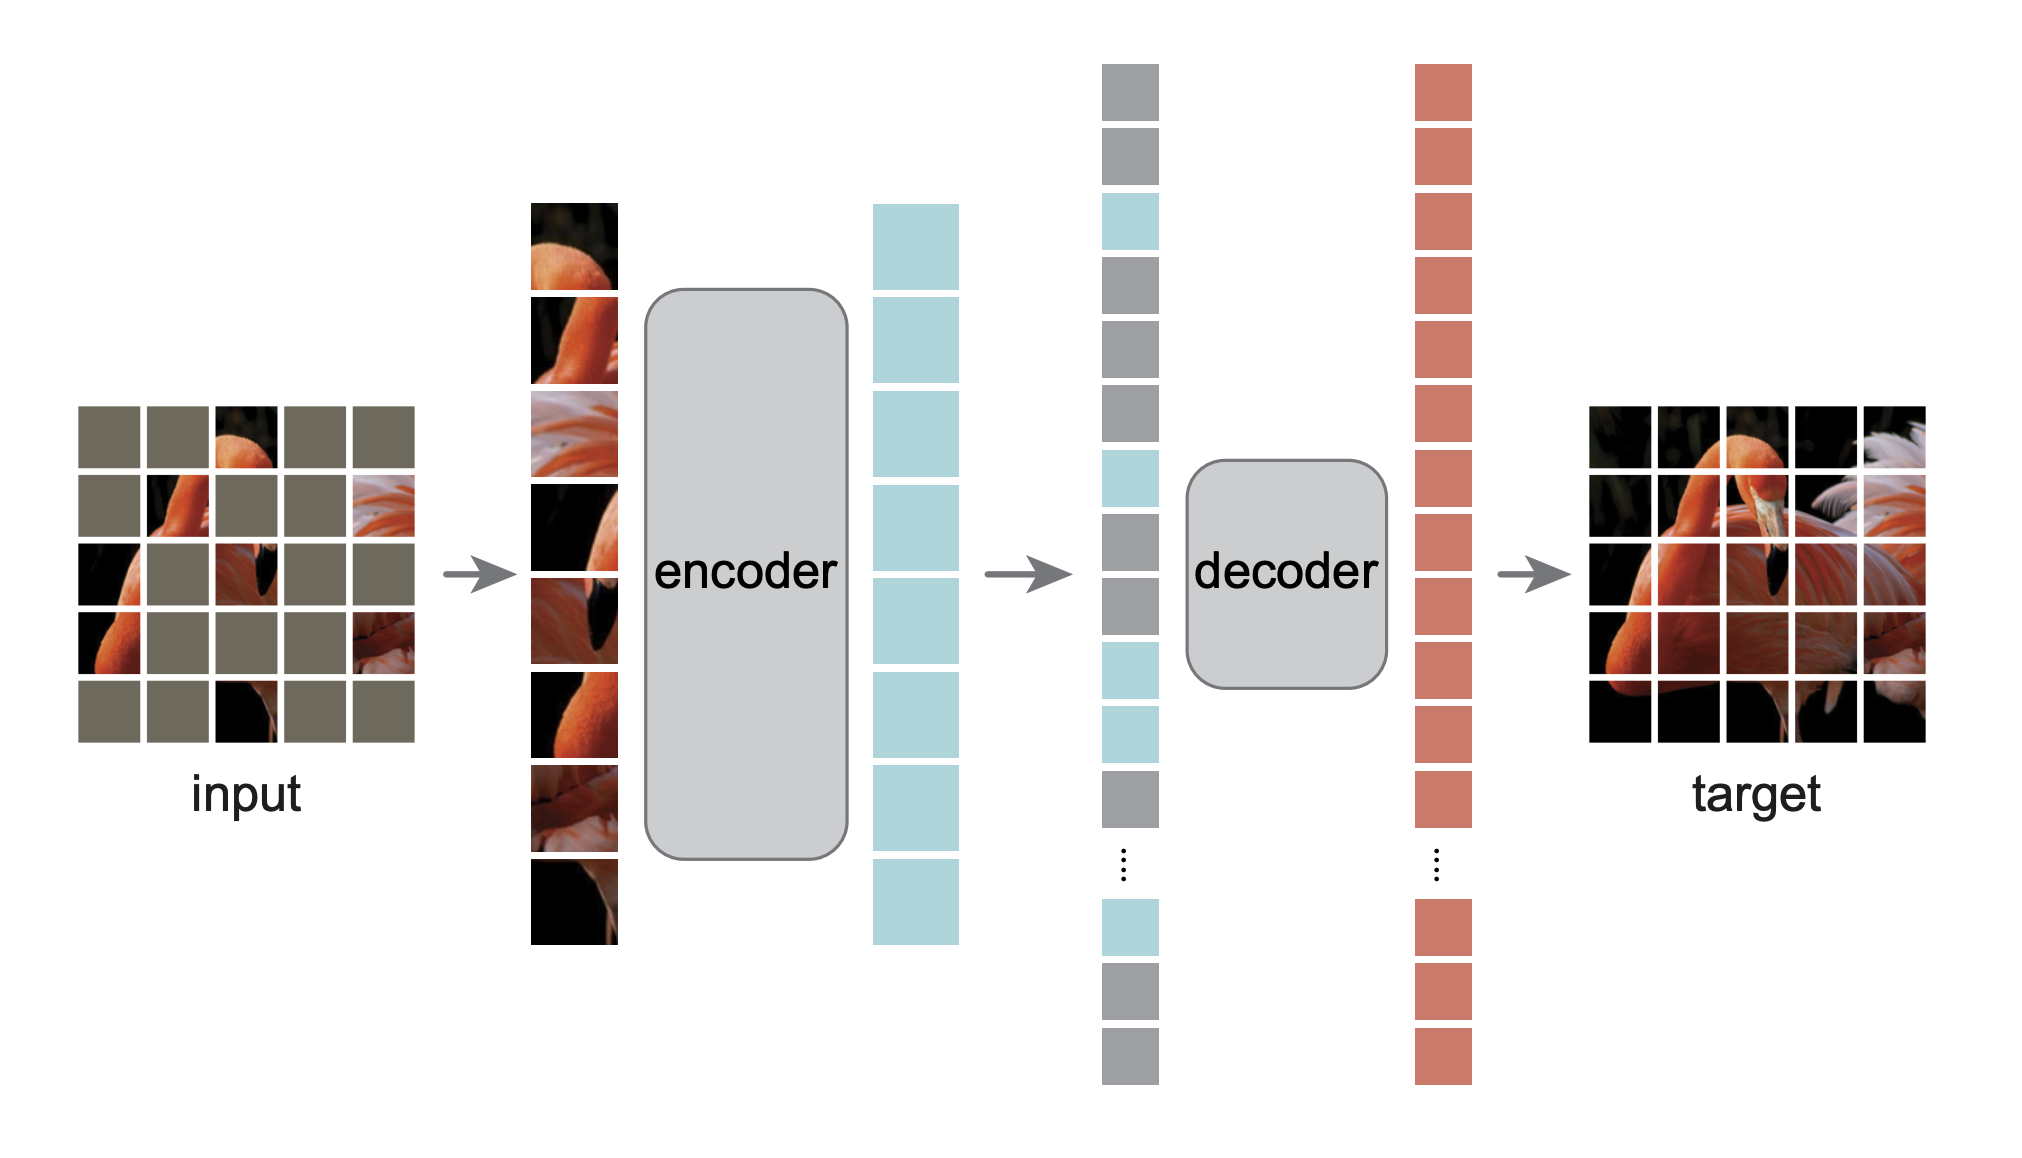 Bạn có thể tìm thấy tất cả các checkpoint ViTMAE gốc dưới tổ chức [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae).
> [!TIP]
> Nhấp vào các mô hình ViTMAE ở thanh bên phải để xem thêm các ví dụ về cách áp dụng ViTMAE cho các tác vụ thị giác.
Ví dụ dưới đây minh họa cách tái tạo các pixel bị thiếu bằng lớp [ViTMAEForPreTraining](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Ghi chú
- ViTMAE thường được sử dụng theo hai giai đoạn. Tiền huấn luyện tự giám sát với [ViTMAEForPreTraining](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEForPreTraining), sau đó loại bỏ bộ giải mã và tinh chỉnh bộ mã hóa. Sau khi tinh chỉnh, trọng số có thể được đưa vào một mô hình như [ViTForImageClassification](/docs/transformers/main/vi/model_doc/vit#transformers.ViTForImageClassification).
- Sử dụng [ViTImageProcessor](/docs/transformers/main/vi/model_doc/vit#transformers.ViTImageProcessor) để chuẩn bị đầu vào.
## Tài nguyên
- Tham khảo [notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb) này để tìm hiểu cách trực quan hóa các pixel được tái tạo từ [ViTMAEForPreTraining](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Tham số:**
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
attention_probs_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-12`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
image_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `224`) : Kích thước (độ phân giải) của mỗi hình ảnh.
patch_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `16`) : Kích thước (độ phân giải) của mỗi patch.
num_channels (`int`, *tuỳ chọn*, mặc định là `3`) : Số lượng kênh đầu vào.
qkv_bias (`bool`, *tùy chọn*, mặc định là `True`) : Có thêm bias vào queries, keys và values hay không.
decoder_num_attention_heads (`int`, *tuỳ chọn*, mặc định là `16`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
decoder_hidden_size (`int`, *tuỳ chọn*, mặc định là `512`) : Kích thước của các biểu diễn ẩn.
decoder_num_hidden_layers (`int`, *tuỳ chọn*, mặc định là 8) : Số lượng lớp ẩn trong bộ giải mã.
decoder_intermediate_size (`int`, *tuỳ chọn*, mặc định là `2048`) : Kích thước của các biểu diễn MLP.
mask_ratio (`float`, *tuỳ chọn*, mặc định là 0.75) : Tỷ lệ số lượng token bị che trong chuỗi đầu vào.
norm_pix_loss (`bool`, *tùy chọn*, mặc định là `False`) : Có huấn luyện với các pixel đã chuẩn hóa hay không (xem Bảng 3 trong bài báo). Việc sử dụng các pixel đã chuẩn hóa đã cải thiện chất lượng biểu diễn trong các thí nghiệm của các tác giả.
Đây là lớp cấu hình để lưu trữ cấu hình của một ViTMAEModel. Nó được sử dụng để khởi tạo một mô hình Vit Mae theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/main/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Tham số:**
config ([ViTMAEConfig](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEConfig)) : Cấu hình cho mô hình.
Mô hình Vit Mae cơ bản, xuất ra các hidden-states thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViTImageProcessor](/docs/transformers/main/vi/model_doc/vit#transformers.ViTImageProcessor). Xem [ViTImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết (`processor_class` sử dụng [ViTImageProcessor](/docs/transformers/main/vi/model_doc/vit#transformers.ViTImageProcessor) để xử lý ảnh).
noise (`torch.FloatTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chủ yếu được sử dụng cho mục đích kiểm thử để kiểm soát tính ngẫu nhiên và duy trì khả năng tái lập
interpolate_pos_encoding (`bool`, *tuỳ chọn*, mặc định `False`) : Có nội suy các mã vị trí được huấn luyện trước hay không. Điều này chủ yếu được sử dụng để dùng mô hình trên các hình ảnh có độ phân giải cao hơn.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
**Trả về:** `ViTMAEModelOutput` hoặc `tuple(torch.FloatTensor)`
Một `ViTMAEModelOutput` hoặc một tuple của `torch.FloatTensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViTMAEConfig](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEConfig)) và đầu vào.
Phương thức forward của [ViTMAEModel](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.FloatTensor` có hình dạng `(batch_size, sequence_length, hidden_size)`, *tùy chọn*) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **mask** (`torch.FloatTensor` có hình dạng `(batch_size, sequence_length)`) -- Tensor chỉ ra các patch bị che (1) và không bị che (0).
- **ids_restore** (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`) -- Tensor chứa chỉ số gốc của các patch (đã xáo trộn) bị che.
- **hidden_states** (`tuple[torch.FloatTensor]`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple các `torch.FloatTensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple[torch.FloatTensor]`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.FloatTensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Tham số:**
config ([ViTMAEConfig](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer ViTMAE với bộ giải mã phía trên để huấn luyện trước tự giám sát.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/main/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/main/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [ViTImageProcessor](/docs/transformers/main/vi/model_doc/vit#transformers.ViTImageProcessor). Xem [ViTImageProcessor.__call__()](/docs/transformers/main/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết (`processor_class` sử dụng [ViTImageProcessor](/docs/transformers/main/vi/model_doc/vit#transformers.ViTImageProcessor) để xử lý ảnh).
noise (`torch.FloatTensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Chủ yếu được sử dụng cho mục đích kiểm thử để kiểm soát tính ngẫu nhiên và duy trì khả năng tái lập
interpolate_pos_encoding (`bool`, *tuỳ chọn*, mặc định `False`) : Có nội suy các mã vị trí được huấn luyện trước hay không. Điều này chủ yếu được sử dụng để dùng mô hình trên các hình ảnh có độ phân giải cao hơn.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
**Trả về:** `ViTMAEForPreTrainingOutput` hoặc `tuple(torch.FloatTensor)`
Một `ViTMAEForPreTrainingOutput` hoặc một tuple của `torch.FloatTensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ViTMAEConfig](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEConfig)) và đầu vào.
Phương thức forward của [ViTMAEForPreTraining](/docs/transformers/main/vi/model_doc/vit_mae#transformers.ViTMAEForPreTraining) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.FloatTensor` có hình dạng `(1,)`) -- Tổn tái tạo pixel.
- **logits** (`torch.FloatTensor` có hình dạng `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Logits tái tạo pixel.
- **mask** (`torch.FloatTensor` có hình dạng `(batch_size, sequence_length)`) -- Tensor chỉ ra các patch bị che (1) và không bị che (0).
- **ids_restore** (`torch.LongTensor` có hình dạng `(batch_size, sequence_length)`) -- Tensor chứa chỉ số gốc của các patch (đã xáo trộn) bị che.
- **hidden_states** (`tuple[torch.FloatTensor]`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple các `torch.FloatTensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple[torch.FloatTensor]`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.FloatTensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```