# ConvNeXT
## Resumen
El modelo ConvNeXT fue propuesto en [A ConvNet for the 2020s](https://huggingface.co/papers/2201.03545) por Zhuang Liu, Hanzi Mao, Chao-Yuan Wu, Christoph Feichtenhofer, Trevor Darrell y Saining Xie. ConvNeXT es un modelo puramente convolucional (ConvNet), inspirado en el diseño de los Vision Transformers, que afirma superarlos en rendimiento.
El resumen del artículo es el siguiente:
*La "década de 1920" del reconocimiento visual comenzó con la introducción de los Vision Transformers (ViTs), que rápidamente superaron a los ConvNets como el modelo de clasificación de imágenes más avanzado. Por otro lado, un ViT estándar enfrenta dificultades al aplicarse a tareas generales de visión por computadora, como la detección de objetos y la segmentación semántica. Son los Transformers jerárquicos (por ejemplo, Swin Transformers) los que reintrodujeron varios sesgos inductivos de los ConvNets, haciendo que los Transformers sean viables en la práctica como un backbone de visión genérico y demostrando un rendimiento notable en una amplia variedad de tareas de visión. Sin embargo, la eficacia de estos enfoques híbridos se atribuye en gran medida a la superioridad intrínseca de los Transformers, en lugar de a los sesgos inductivos inherentes de las convoluciones. En este trabajo, reexaminamos los espacios de diseño y probamos los límites de lo que un ConvNet puro puede lograr. Gradualmente "modernizamos" un ResNet estándar hacia el diseño de un vision Transformer, y descubrimos varios componentes clave que contribuyen a la diferencia de rendimiento a lo largo del camino. El resultado de esta exploración es una familia de modelos de ConvNet puros denominados ConvNeXt. Construidos enteramente con módulos estándar de ConvNet, los ConvNeXt compiten favorablemente con los Transformers en términos de precisión y escalabilidad, alcanzando una precisión top-1 de 87,8 % en ImageNet y superando a los Swin Transformers en la detección de COCO y la segmentación de ADE20K, mientras mantienen la simplicidad y eficiencia de los ConvNets estándar.*
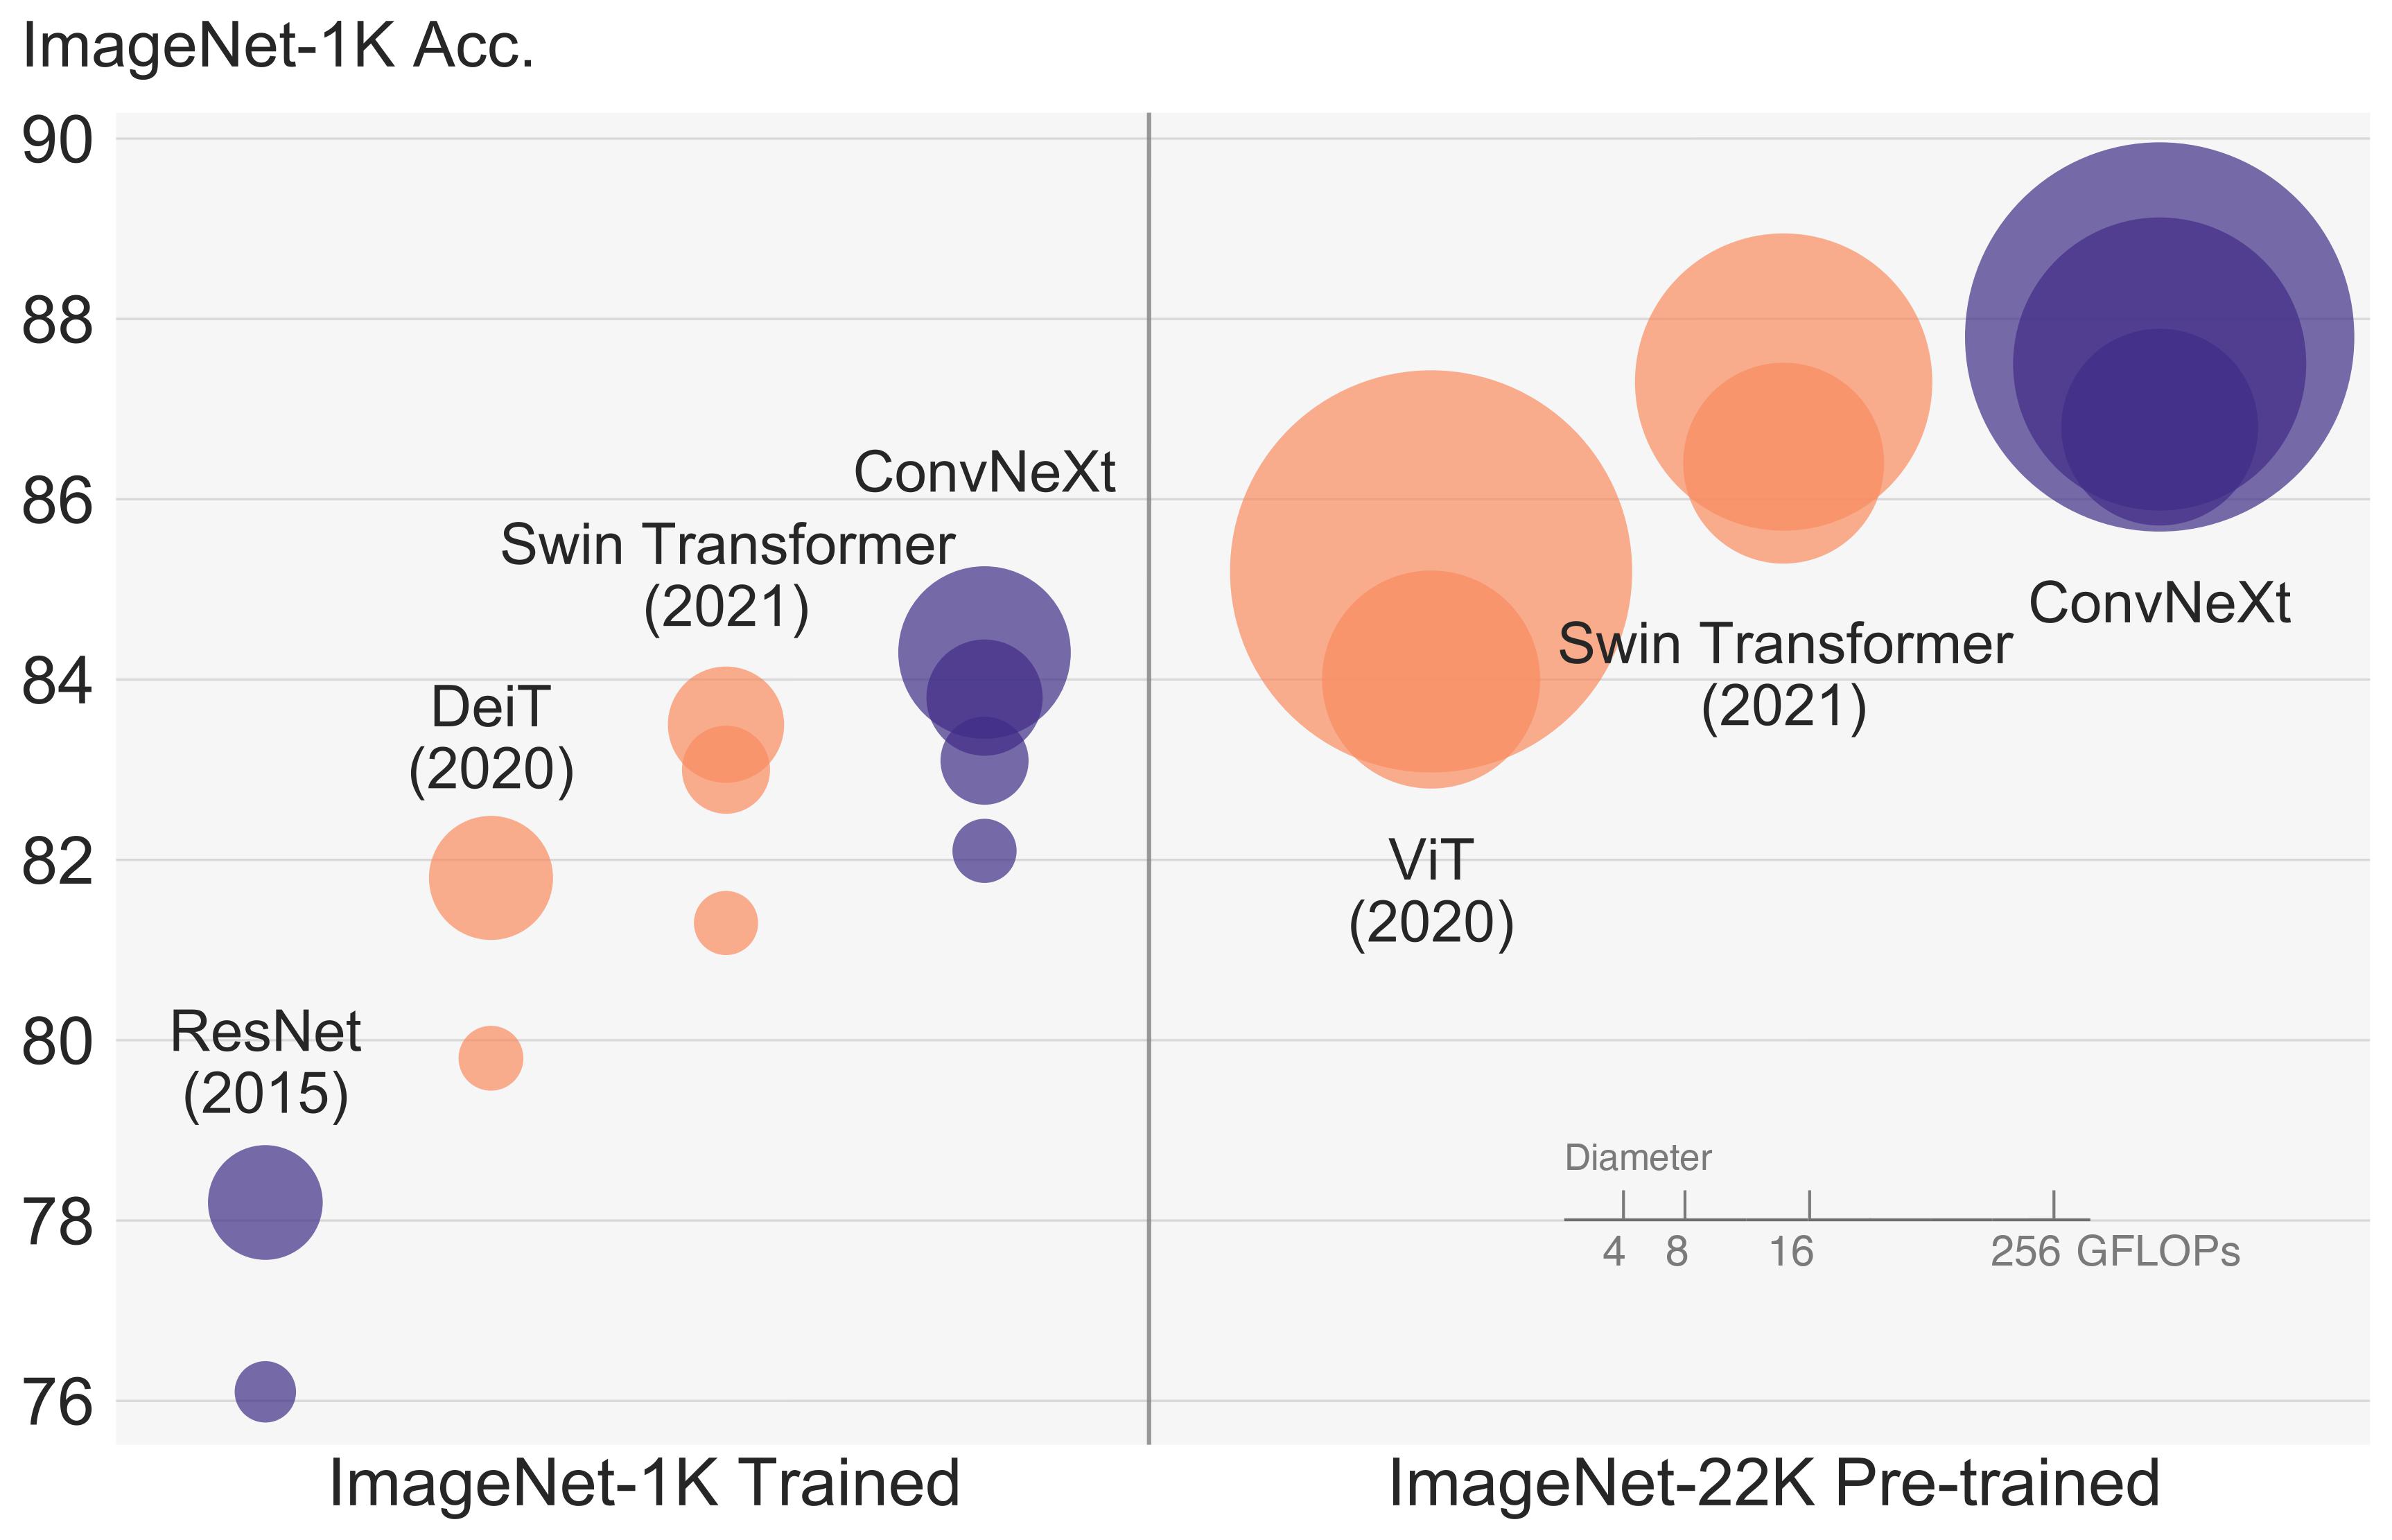 Arquitectura de ConvNeXT. Tomada del artículo original.
Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr). El código original se puede encontrar [aquí](https://github.com/facebookresearch/ConvNeXt).
## Recursos
Una lista de recursos oficiales de Hugging Face y de la comunidad (indicados por 🌎) para ayudarte a empezar con ConvNeXT.
- [ConvNextForImageClassification](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextForImageClassification) es compatible con este [cuaderno](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb).
- Véase también: [Guía de la tarea de clasificación de imágenes](../tasks/image_classification)
Si te interesa enviar un recurso para que se incluya aquí, no dudes en abrir una Pull Request y lo revisaremos. Lo ideal es que el recurso demuestre algo nuevo en lugar de duplicar un recurso existente.
## ConvNextConfig[[transformers.ConvNextConfig]]
#### transformers.ConvNextConfig[[transformers.ConvNextConfig]]
```python
transformers.ConvNextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 4, num_stages: int = 4, hidden_sizes: list[int] | tuple[int, ...] | None = (96, 192, 384, 768), depths: list[int] | tuple[int, ...] | None = (3, 3, 9, 3), hidden_act: str = 'gelu', initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, layer_scale_init_value: float = 1e-06, drop_path_rate: float | int = 0.0, image_size: int | list[int] | tuple[int, int] = 224, _out_features: list[str] | None = None, _out_indices: list[int] | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/configuration_convnext.py#L25)
**Parámetros:**
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `4`) : El tamaño (resolución) de cada parche.
num_stages (`int`, *opcional*, valor predeterminado: 4) : El número de etapas en el modelo.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *opcional*, valor predeterminado `(96, 192, 384, 768)`) : Dimensionalidad (tamaño oculto) en cada etapa del modelo.
depths (`Union[list[int], tuple[int, ...]]`, *opcional*, valor predeterminado `(3, 3, 9, 3)`) : Profundidad de cada capa en el Transformer.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-12`) : El epsilon utilizado por las capas de normalización de capas.
layer_scale_init_value (`float`, *opcional*, valor predeterminado `1e-06`) : Escala a utilizar en las capas de autoatención. 0.1 para base, 1e-6 para large. Establezca 0 para deshabilitar la escala de capa.
drop_path_rate (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : Tasa de drop path para la fusión de parches.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `224`) : El tamaño (resolución) de cada imagen.
Esta es la clase de configuración para almacenar la configuración de un ConvNextModel. Se utiliza para instanciar un modelo Convnext según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/convnext-tiny-224](https://huggingface.co/facebook/convnext-tiny-224)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import ConvNextConfig, ConvNextModel
>>> # Initializing a ConvNext convnext-tiny-224 style configuration
>>> configuration = ConvNextConfig()
>>> # Initializing a model (with random weights) from the convnext-tiny-224 style configuration
>>> model = ConvNextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
#### transformers.ConvNextImageProcessor[[transformers.ConvNextImageProcessor]]
```python
transformers.ConvNextImageProcessor(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/image_processing_convnext.py#L43)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 384}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `3`) : Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
crop_pct (`float`, *kwargs*, *opcional*, valor predeterminado `self.crop_pct`) : Porcentaje de la imagen que se recortará. Solo tiene efecto si size < 384.
Construye un procesador de imágenes ConvNextImageProcessor.
#### preprocess[[transformers.ConvNextImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
#### transformers.ConvNextImageProcessorPil[[transformers.ConvNextImageProcessorPil]]
```python
transformers.ConvNextImageProcessorPil(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/image_processing_pil_convnext.py#L43)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 384}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `3`) : Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.5, 0.5, 0.5]`) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
crop_pct (`float`, *kwargs*, *opcional*, valor predeterminado `self.crop_pct`) : Porcentaje de la imagen que se recortará. Solo tiene efecto si size < 384.
Construye un procesador de imágenes ConvNextImageProcessor.
#### preprocess[[transformers.ConvNextImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## ConvNextModel[[transformers.ConvNextModel]]
#### transformers.ConvNextModel[[transformers.ConvNextModel]]
```python
transformers.ConvNextModel(config: ConvNextConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L251)
**Parámetros:**
config ([ConvNextConfig](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Convnext básico que emite estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ConvNextModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L265)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener mediante [ConvNextImageProcessor](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextImageProcessor). Consulte [ConvNextImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles (`processor_class` utiliza [ConvNextImageProcessor](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextImageProcessor) para procesar las imágenes).
**Devuelve:** `BaseModelOutputWithPoolingAndNoAttention` o `tuple(torch.Tensor)`
Un `BaseModelOutputWithPoolingAndNoAttention` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ConvNextConfig](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextConfig)) y las entradas.
El método forward de [ConvNextModel](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_channels, height, width)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size)`) -- Estado oculto de la última capa después de una operación de agrupación en las dimensiones espaciales.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, devuelto cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, num_channels, height, width)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
Ejemplo:
```python
```
## ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
#### transformers.ConvNextForImageClassification[[transformers.ConvNextForImageClassification]]
```python
transformers.ConvNextForImageClassification(config: ConvNextConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L293)
**Parámetros:**
config ([ConvNextConfig](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo ConvNext con una cabeza de clasificación de imágenes en la parte superior (una capa lineal sobre las características agrupadas), por ejemplo, para ImageNet.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ConvNextForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/convnext/modeling_convnext.py#L311)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener mediante [ConvNextImageProcessor](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextImageProcessor). Consulte [ConvNextImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles (`processor_class` utiliza [ConvNextImageProcessor](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextImageProcessor) para procesar las imágenes).
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación/regresión de imagen. Los índices deben estar en `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1` se calcula una pérdida de regresión (pérdida de error cuadrático medio), si `config.num_labels > 1` se calcula una pérdida de clasificación (entropía cruzada).
**Devuelve:** [ImageClassifierOutputWithNoAttention](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) o `tuple(torch.Tensor)`
Un [ImageClassifierOutputWithNoAttention](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.ImageClassifierOutputWithNoAttention) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ConvNextConfig](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextConfig)) y las entradas.
El método forward de [ConvNextForImageClassification](/docs/transformers/v5.23.0/es/model_doc/convnext#transformers.ConvNextForImageClassification) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación (o de regresión si config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, devuelto cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada etapa) de forma `(batch_size, num_channels, height, width)`. Estados ocultos (también llamados mapas de características) del modelo en la salida de cada etapa.
Ejemplo:
```python
>>> from transformers import AutoImageProcessor, ConvNextForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/convnext-tiny-224")
>>> model = ConvNextForImageClassification.from_pretrained("facebook/convnext-tiny-224")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```