# LLaVa
## Genel Bakış
LLaVa, GPT tarafından üretilen çok modlu talimat izleme verileri üzerinde LlamA/Vicuna'nın ince ayarlanmasıyla eğitilmiş açık kaynaklı bir sohbet botudur. Transformer mimarisine dayalı otoregresif bir dil modelidir. Başka bir deyişle, sohbet / talimatlar için ince ayarı yapılmış LLM'lerin çok modlu bir versiyonudur.
LLaVa modeli, Haotian Liu, Chunyuan Li, Yuheng Li ve Yong Jae Lee tarafından [Visual Instruction Tuning](https://huggingface.co/papers/2304.08485) makalesinde önerilmiş ve [Improved Baselines with Visual Instruction Tuning](https://huggingface.co/papers/2310.03744) makalesinde iyileştirilmiştir.
Makalenin özeti aşağıdaki gibidir:
*Büyük çok modlu modeller (LMM) son zamanlarda görsel talimat ayarlamasında umut verici ilerlemeler göstermiştir. Bu notta, LLaVA'daki tam bağlı görsel-dil çapraz modlu bağlayıcının (connector) şaşırtıcı derecede güçlü ve veri verimli olduğunu gösteriyoruz. LLaVA'ya basit değişiklikler uygulayarak, yani CLIP-ViT-L-336px'i bir MLP projeksiyonu ile kullanmak ve basit yanıt biçimlendirme istemcileriyle akademik görev odaklı VQA verisi eklemek, 11 farklı ölçekte (benchmark) en iyi performansı (state-of-the-art) elde eden daha güçlü baz çizgileri (baselines) kuruyoruz. Son 13B kontrol noktamız (checkpoint) yalnızca 1,2M halka açık veriyi kullanıyor ve tek bir 8-A100 düğümünde tam eğitimi yaklaşık 1 günde tamamlıyor. Bu çalışmanın, en iyi performans gösteren LMM araştırmalarını daha erişilebilir kılmasını umuyoruz. Kod ve model halka açık olarak kullanılabilir olacaktır*
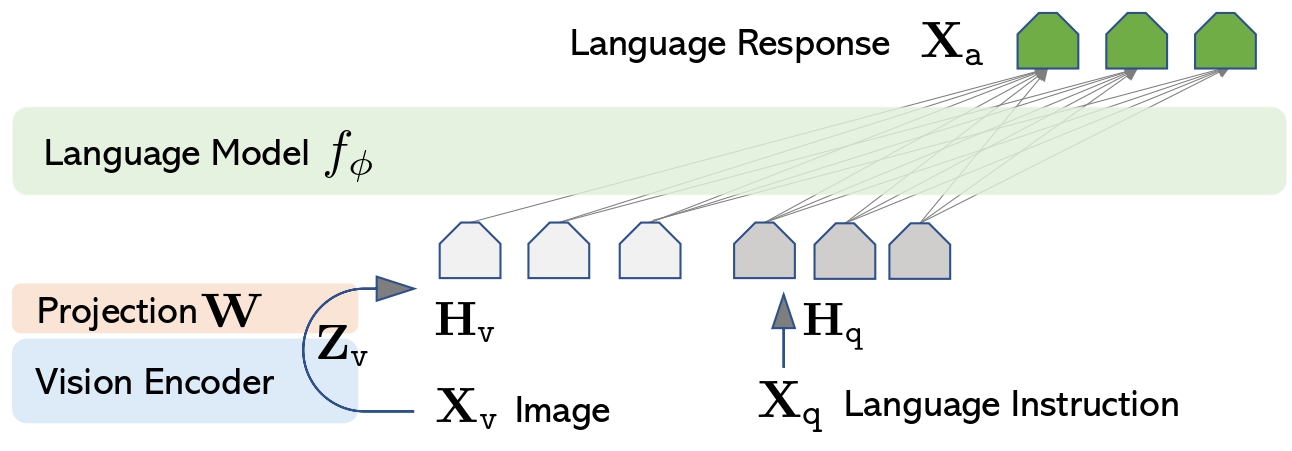 LLaVa mimarisi. Orijinal makaleden alınmıştır.
Bu model [ArthurZ](https://huggingface.co/ArthurZ) ve [ybelkada](https://huggingface.co/ybelkada) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/haotian-liu/LLaVA/tree/main/llava) bulunabilir.
> [!TIP]
> [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) içinde `use_kernels=True` değerini ayarlayarak desteklenen katmanları Hub'daki optimize edilmiş çekirdeklerle değiştirin. Daha fazla bilgi için [Çekirdekleri yükleme](../kernel_doc/loading_kernels) bölümüne bakın.
## Kullanım ipuçları
- Toplu üretim hesaplama yaparken daha doğru sonuçlar elde edilebilmesi için kullanıcılara `padding_side="left"` kullanmalarını öneririz. Üretimden önce `processor.tokenizer.padding_side = "left"` çağrısını yaptığınızdan emin olun.
- Modelin aynı istemde birden fazla görüntüyü işleyecek şekilde açıkça eğitilmediğini unutmayın; bu teknik olarak mümkün olsa da, sonuçlarda doğruluk sorunları yaşayabilirsiniz.
> [!NOTE]
> v4.46 sürümünden sonra yayınlanan LLaVA modelleri, `processor.patch_size = {{patch_size}}`, `processor.num_additional_image_tokens = {{num_additional_image_tokens}}` ve `processor.vision_feature_select_strategy = {{vision_feature_select_strategy}}` eklenmesi konusunda uyarılar verecektir. Model checkpoint'ine sahipseniz, bu öznitelikleri işlemciye (processor) eklemeniz şiddetle önerilir; sahip değilseniz bir PR açmanız önerilir.
Bu öznitelikleri eklemek, LLaVA'nın her görsel için gereken görsel jeton sayısını tahmin etmeye çalışacağı ve jeton sayısı kadar `` yer tutucusuyla metni genişleteceği anlamına gelir. Genellikle görsel başına yaklaşık 500 jeton bulunur, bu nedenle gömleştirmelerin birleştirilmesi sırasında başarısızlık yaşanmaması için metnin kırpılmadığından emin olun. Öznitelikler, model yapılandırmasından `model.config.vision_config.patch_size` veya `model.config.vision_feature_select_strategy` olarak elde edilebilir. `num_additional_image_tokens`, görsele dayalı mimari bir CLS jetonu ekliyorsa `1`, görsel yamalarına ek olarak hiçbir şey eklenmiyorsa `0` olmalıdır.
### Chat Şablonlarıyla İstemleri Biçimlendirme
Her **checkpoint**, altta yatan büyük dil modeli omurgasına bağlı olarak belirli bir istem formatıyla eğitilir. Doğru biçimlendirmeyi sağlamak için işleyicinin `apply_chat_template` yöntemini kullanın.
**Önemli:**
- Bir konuşma geçmişi oluşturmanız gerekir — düz bir dize geçirmek işe yaramaz.
- Her mesaj, `"role"` ve `"content"` anahtarlarına sahip bir sözlük olmalıdır.
- `"content"`, `"text"` ve `"image"` gibi farklı modaliteler için sözlüklerden oluşan bir liste olmalıdır.
Girdinizi nasıl yapılandıracağınızın bir örneği aşağıdadır. [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf) ve metin ile görüntüden oluşan bir sohbet geçmişi kullanacağız. Her içerik alanı, aşağıdaki gibi sözlüklerden oluşan bir liste olmalıdır:
```python
from transformers import AutoProcessor
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image"},
{"type": "text", "text": "What’s shown in this image?"},
],
},
{
"role": "assistant",
"content": [{"type": "text", "text": "This image shows a red stop sign."},]
},
{
"role": "user",
"content": [
{"type": "text", "text": "Describe the image in more details."},
],
},
]
text_prompt = processor.apply_chat_template(conversation, add_generation_prompt=True)
# Note that the template simply formats your prompt, you still have to tokenize it and obtain pixel values for your images
print(text_prompt)
"USER: \nUSER: Describe the image in more details. ASSISTANT:"
```
- Kendi sohbet prompt'unuzu oluşturmak istiyorsanız, aşağıda her bir llava checkpoint'inin kabul ettiği prompt formatlarının listesi yer almaktadır:
[llava-interleave modelleri](https://huggingface.co/collections/llava-hf/llava-interleave-668e19a97da0036aad4a2f19) aşağıdaki biçimi gerektirir:
```bash
"<|im_start|>user \nWhat is shown in this image?<|im_end|><|im_start|>assistant"
```
Birden fazla tur için sohbet:
```bash
"<|im_start|>user \n<|im_end|><|im_start|>assistant <|im_end|><|im_start|>user \n<|im_end|><|im_start|>assistant "
```
[llava-1.5 modelleri](https://huggingface.co/collections/llava-hf/llava-15-65f762d5b6941db5c2ba07e0) aşağıdaki biçimi gerektirir:
```bash
"USER: \n ASSISTANT:"
```
Birden fazla tur için sohbet:
```bash
"USER: \n ASSISTANT: USER: ASSISTANT: USER: ASSISTANT:"
```
🚀 **Bonus:** `transformers>=4.49.0` kullanıyorsanız, `apply_chat_template` ile vektörlü bir çıktı da alabilirsiniz. Kullanımına dair daha fazla ayrıntı için aşağıdaki **Kullanım Örnekleri** bölümüne bakın.
## Kullanım örnekleri
### Tek girişli çıkarım
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
conversation = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
conversation,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
### Toplu çıkarım
LLaVa ayrıca toplu çıkarımı da destekler. Bunu nasıl yapabileceğiniz aşağıda gösterilmektedir:
```python
import torch
from transformers import AutoProcessor, LlavaForConditionalGeneration
# Load the model in half-precision
model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", device_map="auto")
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
# Prepare a batch of two prompts
conversation_1 = [
{
"role": "user",
"content": [
{"type": "image", "url": "https://www.ilankelman.org/stopsigns/australia.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
conversation_2 = [
{
"role": "user",
"content": [
{"type": "image", "url": "http://images.cocodataset.org/val2017/000000039769.jpg"},
{"type": "text", "text": "What is shown in this image?"},
],
},
]
inputs = processor.apply_chat_template(
[conversation_1, conversation_2],
add_generation_prompt=True,
tokenize=True,
return_dict=True,
padding=True,
return_tensors="pt"
).to(model.device, torch.float16)
# Generate
generate_ids = model.generate(**inputs, max_new_tokens=30)
processor.batch_decode(generate_ids, skip_special_tokens=True)
```
## Orijinal uygulamanın yeniden oluşturulmasına ilişkin not
[orijinal uygulamanın](https://github.com/haotian-liu/LLaVA/tree/main) logits'leriyle eşleşmesi için, `LlavaImageProcessor` örneği oluşturulurken ayrıca `do_pad=True` parametresinin belirtilmesi gerekir:
```python
from transformers import LlavaImageProcessor
image_processor = LlavaImageProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf", do_pad=True)
```
### Flash Attention 2 Kullanımı
Flash Attention 2, önceki optimizasyonun daha hızlı ve optimize edilmiş bir sürümüdür; lütfen [performans belgelerindeki Flash Attention 2 bölümüne](https://huggingface.co/docs/transformers/perf_infer_gpu_one) bakınız.
## Kaynaklar
LLaVa ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- 4-bit çıkarımı kullanarak ücretsiz katmanlı bir Google Colab örneğinde Llava'yı çalıştırmanın nasıl yapılacağını gösteren bir [Google Colab demosu](https://colab.research.google.com/drive/1qsl6cd2c8gGtEW1xV5io7S8NHh-Cp1TV?usp=sharing).
- Toplu çıkarımı gösteren [benzer bir defter](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/LLaVa/Inference_with_LLaVa_for_multimodal_generation.ipynb). 🌎
## LlavaConfig[[transformers.LlavaConfig]]
#### transformers.LlavaConfig[[transformers.LlavaConfig]]
```python
transformers.LlavaConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, image_token_index: int = 32000, image_seq_length: int = 576, projector_hidden_act: str = 'gelu', vision_feature_select_strategy: typing.Literal['default', 'full'] = 'default', vision_feature_layer: int | list[int] = -2, multimodal_projector_bias: bool = True, tie_word_embeddings: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/configuration_llava.py#L26)
**Parametreler:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Görüntü iskeletinin yapılandırma nesnesi veya sözlüğü.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Metin omurgasının yapılandırma nesnesi veya sözlüğü.
image_token_index (`int`, *isteğe bağlı*, varsayılan `32000`) : Girdi görselleri için yer tutucu olarak kullanılan görsel jeton indeksi.
image_seq_length (`int`, *isteğe bağlı*, varsayılan `576`) : Bir görsel gömme dizisinin uzunluğu.
projector_hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çok modlu projeksiyoncu tarafından kullanılan aktivasyon fonksiyonu.
vision_feature_select_strategy (`Literal[default, full]`, *isteğe bağlı*, varsayılan `default`) : Görüntü omurgasından (vision backbone) görüntü özelliğini seçmek için kullanılan özellik seçme stratejisi.
vision_feature_layer (`Union[int, list[int]]`, *isteğe bağlı*, varsayılan `-2`) : Görüntü özelliğinin seçileceği katmanın indeksi. Birden fazla indeks sağlanırsa, ilgili indekslere ait görüntü özellikleri birleştirilerek görüntü özellikleri oluşturulur.
multimodal_projector_bias (`bool`, *isteğe bağlı*, varsayılan `True`) : Çok modlu projeksiyonda sapma (bias) kullanılıp kullanılmayacağı.
tie_word_embeddings (`bool`, *isteğe bağlı*, varsayılan `False`) : Ağırlık gömme bağlamalarının, modelin `tied_weights_keys` eşlemesine göre yapılıp yapılmayacağını belirtir.
Bu, bir LlavaModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Llava modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [llava-hf/llava-1.5-7b-hf](https://huggingface.co/llava-hf/llava-1.5-7b-hf) ile benzer bir yapılandırmaya yol açar.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import LlavaForConditionalGeneration, LlavaConfig, CLIPVisionConfig, LlamaConfig
>>> # Initializing a CLIP-vision config
>>> vision_config = CLIPVisionConfig()
>>> # Initializing a Llama config
>>> text_config = LlamaConfig()
>>> # Initializing a Llava llava-1.5-7b style configuration
>>> configuration = LlavaConfig(vision_config, text_config)
>>> # Initializing a model from the llava-1.5-7b style configuration
>>> model = LlavaForConditionalGeneration(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## LlavaImageProcessor[[transformers.LlavaImageProcessor]]
#### transformers.LlavaImageProcessor[[transformers.LlavaImageProcessor]]
```python
transformers.LlavaImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/image_processing_llava.py#L38)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 224}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
LlavaImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.LlavaImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
#### transformers.LlavaImageProcessorPil[[transformers.LlavaImageProcessorPil]]
```python
transformers.LlavaImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/image_processing_pil_llava.py#L31)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 224}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.48145466, 0.4578275, 0.40821073]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.26862954, 0.26130258, 0.27577711]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
LlavaImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.LlavaImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
image_like_kwargs (`dict[str, Any]`, *isteğe bağlı*) : Ek görüntü benzeri girdiler için geliştirici bayrağı; bu girdiler de ön işleme tabi tutulacaktır. Girdileri kwarg olarak geçirmenin çalışmadığı durumlarda kullanın. Örneğin, `preprocess(images, masks=masks)` tercih edilen seçenektir ancak bazı modellerde argüman öncelik sorunlarına yol açar. Bu durumlarda bunun yerine `preprocess(images, image_like_inputs={"masks": masks})` kullanılabilir.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
Bir görüntüyü veya bir görüntü grubunu ön işleme tabi tutun.
## LlavaProcessor[[transformers.LlavaProcessor]]
#### transformers.LlavaProcessor[[transformers.LlavaProcessor]]
```python
transformers.LlavaProcessor(image_processor = None, tokenizer = None, patch_size = None, vision_feature_select_strategy = None, chat_template = None, image_token = '', num_additional_image_tokens = 0, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/processing_llava.py#L32)
**Parametreler:**
image_processor (`LlavaImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`TokenizersBackend`) : Tokenizer zorunlu bir girdidir.
patch_size (`int`, *isteğe bağlı*) : Görüntü kulesinden gelen yama boyutu.
vision_feature_select_strategy (`str`, *isteğe bağlı*) : Görüntü omurgasından (vision backbone) görüntü özelliğini seçmek için kullanılan özellik seçme stratejisi. Modelin yapılandırmasıyla aynı olmalıdır
chat_template (`str`) : Bir sohbet içindeki mesaj listelerini tokenize edilebilir bir metne dönüştürmek için kullanılan bir Jinja şablonu.
image_token (`str`, *isteğe bağlı*, varsayılan `""`) : Görsel konumunu belirtmek için kullanılan özel jeton.
num_additional_image_tokens (`int`, *opsiyonel*, varsayılan 0) : CLS (+1) gibi, görsel gömme (embedding)lere eklenen ek token sayısı. Omurga (backbone) CLS veya başka ek tokenler eklemiyorsa, bu argümanı ayarlamanıza gerek yoktur.
Bir görüntü işleyiciyi ve bir belirteç oluşturucuyu tek bir işleyicide birleştiren bir LlavaProcessor oluşturur.
[LlavaProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaProcessor), [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) ve [TokenizersBackend](/docs/transformers/v5.23.0/tr/main_classes/tokenizer#transformers.TokenizersBackend) sınıflarının tüm işlevlerini sunar. Daha fazla bilgi için [~LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) ve [~TokenizersBackend](/docs/transformers/v5.23.0/tr/main_classes/tokenizer#transformers.TokenizersBackend) belgelerine bakın.
#### __call__[[transformers.LlavaProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak video. Piksel değerleri 0 ile 255 arasında değişen tek bir video veya video grubu beklenir. Piksel değerleri 0 ile 1 arasında olan videoları geçiriyorsanız, `do_rescale=False` olarak ayarlayın.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *isteğe bağlı*) : Hazırlanacak ses veya sesler grubu. Her ses, bir NumPy dizisi veya PyTorch tensörü olabilir. NumPy dizisi/PyTorch tensörü durumunda, her sesin şekli (C, T) olmalıdır; burada C kanal sayısı, T ise sesin örnek uzunluğudur.
return_mm_token_type_ids (`bool`, *kwargs*) : Çok modlu yer tutucu token konumlarını gösteren çok modlu token türü kimliklerini döndürüp döndürmeyeceğini belirtir.
return_text_replacement_offsets (`bool`, *kwargs*) : Her çok modlu yer tutucu ve ikamesi için karakter ofsetlerinin döndürülüp döndürülmemesi.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.ProcessingKwargs), *opsiyonel*) : Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
## LlavaModel[[transformers.LlavaModel]]
#### transformers.LlavaModel[[transformers.LlavaModel]]
```python
transformers.LlavaModel(config: LlavaConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L131)
**Parametreler:**
config ([LlavaConfig](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Bir görme omurgası ve bir dil modelinden oluşan, ancak bir dil modelleme başlığı içermeyen Llava modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.LlavaModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L216)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)'a bakın ([LlavaProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaProcessor), görüntü işleme için [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanır).
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
position_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizisi token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *isteğe bağlı*) : Sıralı çözümlemeyi hızlandırmak için kullanılabilen, önceden hesaplanmış gizli durumlar (self-attention bloklarındaki ve cross-attention bloklarındaki anahtar ve değerler). Bu genellikle, `use_cache=True` veya `config.use_cache=True` olduğunda, çözümlemenin önceki bir aşamasında modelin döndürdüğü `past_key_values` değerlerinden oluşur. Girdi olarak yalnızca [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneği kabul edilir, bkz. [kv cache kılavuzu](https://huggingface.co/docs/transformers/en/kv_cache). `past_key_values` geçirilmezse, varsayılan olarak [DynamicCache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.DynamicCache) başlatılır. Model, girdi olarak verilen aynı önbellek biçimini çıktı olarak verecektir. `past_key_values` kullanılıyorsa, kullanıcının, bu modele geçmiş anahtar-değer durumları verilmemiş olan, yalnızca işlenmemiş `input_ids` değerlerini (şekli `(batch_size, unprocessed_length)` olan) girmesi beklenir; bunun yerine, şekli `(batch_size, sequence_length)` olan tüm `input_ids` değerleri girilmez.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
vision_feature_layer (`Union[int, list[int]]`, *isteğe bağlı*) : Görüntü özelliğinin seçileceği katmanın indeksi. Birden fazla indeks sağlanırsa, ilgili indekslere ait görüntü özellikleri birleştirilerek görüntü özellikleri oluşturulur.
vision_feature_select_strategy (`str`, *isteğe bağlı*) : Görüntü omurgasından (vision backbone) görüntü özelliğini seçmek için kullanılan özellik seçme stratejisi. `"default"` veya `"full"` değerlerinden biri olabilir.
image_sizes (`torch.Tensor`, şekli `(batch_size, 2)`, *isteğe bağlı*) : Toplu işlemdeki görüntülerin boyutları, her görüntü için (yükseklik, genişlik).
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *isteğe bağlı*) : Anahtarları desteklenen modaliteler, değerleri ise o modalite için kodlanmış çıktılar olan bir sözlük. Her kodlanmış çıktı, (`pooler_output`, *isteğe bağlı*: `last_hidden_states`, *isteğe bağlı*: `hidden_states`, *isteğe bağlı*: `attentions`) `pooler_output` `(batch_size, sequence_length, hidden_size)` boyutunda, *isteğe bağlı*) şeklindedir ve kodlayıcının çok modlu özelliklerinin metin gömme (embedding) değerleriyle birleştirilmiş bir dizisidir.
**Dönüş:** `LlavaModelOutputWithPast` veya `tuple(torch.Tensor)`
Bir `LlavaModelOutputWithPast` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([LlavaConfig](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[LlavaModel](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
`past_key_values` kullanılırsa, yalnızca `(batch_size, 1, hidden_size)` biçimindeki dizilerin son gizli durumu (hidden-state) çıktı olarak verilir.
- **past_key_values** (`Cache`, *isteğe bağlı*, `use_cache=True` geçirildiğinde veya `config.use_cache=True` olduğunda döndürülür) -- Bir [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneğidir. Daha fazla ayrıntı için [kv cache kılavuzumuza](https://huggingface.co/docs/transformers/en/kv_cache) bakın.
Sıralı çözümlemeyi hızlandırmak için (bkz. `past_key_values` girdisi) kullanılabilen, önceden hesaplanmış gizli durumları (self-attention bloklarındaki anahtar ve değerler) içerir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **image_hidden_states** (`torch.Tensor`, *isteğe bağlı*) -- `(batch_size, num_images, sequence_length, hidden_size)` boyutunda bir `torch.Tensor`. Görüntü kodlayıcısı tarafından üretilen ve son gizli durum projeksiyonundan sonra modelin image_hidden_states'i.
#### get_image_features[[transformers.LlavaModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, image_sizes: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L140)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakınız ([LlavaProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaProcessor), görüntü işleme için [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanır).
vision_feature_layer (`Union[int, list[int]]`, *isteğe bağlı*) : Görüntü özelliğinin seçileceği katmanın indeksi. Birden fazla indeks sağlanırsa, ilgili indekslere ait görüntü özellikleri birleştirilerek görüntü özellikleri oluşturulur.
vision_feature_select_strategy (`str`, *isteğe bağlı*) : Görüntü omurgasından (vision backbone) görüntü özelliğini seçmek için kullanılan özellik seçme stratejisi. `"default"` veya `"full"` değerlerinden biri olabilir.
image_sizes (`torch.Tensor`, şekli `(batch_size, 2)`, *isteğe bağlı*) : Toplu işlemdeki görüntülerin boyutları, her görüntü için (yükseklik, genişlik).
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([LlavaConfig](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
Görme kulesinden görüntü son gizli durumlarını alır ve çok modlu projeksiyonu uygular.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
#### get_placeholder_mask[[transformers.LlavaModel.get_placeholder_mask]]
```python
get_placeholder_mask(input_ids: LongTensor, inputs_embeds: Tensor, image_features: Tensor)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L192)
`input_ids` veya `inputs_embeds` içinden çok modlu yer tutucu maskesini alır ve yer tutucu belirteç sayısının çok modlu özelliklerin uzunluğuna eşit olduğunu kontrol eder. Uzunluklar farklıysa bir hata oluşturulur.
## LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
#### transformers.LlavaForConditionalGeneration[[transformers.LlavaForConditionalGeneration]]
```python
transformers.LlavaForConditionalGeneration(config: LlavaConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L281)
**Parametreler:**
config ([LlavaConfig](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Bir görme omurgası ve bir dil modelinden oluşan LLAVA modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.LlavaForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, labels: typing.Optional[torch.LongTensor] = None, logits_to_keep: typing.Union[int, torch.Tensor] = 0, image_sizes: typing.Optional[torch.Tensor] = None, mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L309)
**Parametreler:**
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak dolgu (padding) yoksayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) ve [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) yöntemlerine bakın. [Girdi kimlikları (input IDs) nedir?](../glossary#input-ids)
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)'a bakın ([LlavaProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaProcessor), görüntü işleme için [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanır).
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
position_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi dizisi token'larının konum gömme (position embeddings) içindeki konum indeksleri. `[0, config.n_positions - 1]` aralığında seçilir. [Konum kimlikleri (position IDs) nedir?](../glossary#position-ids)
past_key_values (`~cache_utils.Cache`, *isteğe bağlı*) : Sıralı çözümlemeyi hızlandırmak için kullanılabilen, önceden hesaplanmış gizli durumlar (self-attention bloklarındaki ve cross-attention bloklarındaki anahtar ve değerler). Bu genellikle, `use_cache=True` veya `config.use_cache=True` olduğunda, çözümlemenin önceki bir aşamasında modelin döndürdüğü `past_key_values` değerlerinden oluşur. Girdi olarak yalnızca [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneği kabul edilir, bkz. [kv cache kılavuzu](https://huggingface.co/docs/transformers/en/kv_cache). `past_key_values` geçirilmezse, varsayılan olarak [DynamicCache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.DynamicCache) başlatılır. Model, girdi olarak verilen aynı önbellek biçimini çıktı olarak verecektir. `past_key_values` kullanılıyorsa, kullanıcının, bu modele geçmiş anahtar-değer durumları verilmemiş olan, yalnızca işlenmemiş `input_ids` değerlerini (şekli `(batch_size, unprocessed_length)` olan) girmesi beklenir; bunun yerine, şekli `(batch_size, sequence_length)` olan tüm `input_ids` değerleri girilmez.
inputs_embeds (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) : `input_ids` parametresini iletmek yerine, gömülü bir temsil doğrudan iletmeyi tercih edebilirsiniz. Bu, `input_ids` indekslerini ilgili vektörlere dönüştürme biçimi üzerinde modelin dahili gömme arama matrisine kıyasla daha fazla kontrol sahibi olmak istiyorsanız faydalıdır.
vision_feature_layer (`Union[int, list[int]]`, *isteğe bağlı*) : Görüntü özelliğinin seçileceği katmanın indeksi. Birden fazla indeks sağlanırsa, ilgili indekslere ait görüntü özellikleri birleştirilerek görüntü özellikleri oluşturulur.
vision_feature_select_strategy (`str`, *isteğe bağlı*) : Görüntü omurgasından (vision backbone) görüntü özelliğini seçmek için kullanılan özellik seçme stratejisi. `"default"` veya `"full"` değerlerinden biri olabilir.
labels (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Maskeli dil modelleme kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.vocab_size]` aralığında olmalı ya da -100 olmalı (`input_ids` docstring'ine bakın). Endeksleri `-100` olarak ayarlanan tokenlar yok sayılır (maskelenir), kayıp yalnızca `[0, ..., config.vocab_size]` aralığında etiketlere sahip tokenlar için hesaplanır.
logits_to_keep (`Union[int, torch.Tensor]`, *isteğe bağlı*, varsayılan `0`) : `int` ise, son `logits_to_keep` token için logits hesaplanır. `0` ise, tüm `input_ids` için logits hesaplanır (özel durum). Üretim için yalnızca son token'ın logits'ine ihtiyaç duyulur ve bunların yalnızca o token için hesaplanması bellek tasarrufu sağlar; bu, uzun diziler veya büyük sözlük boyutu için oldukça önemli hale gelir. `torch.Tensor` ise, dizi uzunluğu boyutunda tutulacak indekslere karşılık gelen 1B olmalıdır. Bu, paketlenmiş tensor biçimini (batch ve dizi uzunluğu için tek boyut) kullanırken faydalıdır.
image_sizes (`torch.Tensor`, şekli `(batch_size, 2)`, *isteğe bağlı*) : Toplu işlemdeki görüntülerin boyutları, her görüntü için (yükseklik, genişlik).
mm_encoder_outputs (`dict[str, ~modeling_outputs.BaseModelOutputWithPooling]`, *isteğe bağlı*) : Anahtarları desteklenen modaliteler, değerleri ise o modalite için kodlanmış çıktılar olan bir sözlük. Her kodlanmış çıktı, (`pooler_output`, *isteğe bağlı*: `last_hidden_states`, *isteğe bağlı*: `hidden_states`, *isteğe bağlı*: `attentions`) `pooler_output` `(batch_size, sequence_length, hidden_size)` boyutunda, *isteğe bağlı*) şeklindedir ve kodlayıcının çok modlu özelliklerinin metin gömme (embedding) değerleriyle birleştirilmiş bir dizisidir.
**Dönüş:** `LlavaCausalLMOutputWithPast` veya `tuple(torch.Tensor)`
Bir `LlavaCausalLMOutputWithPast` veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([LlavaConfig](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[LlavaForConditionalGeneration](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaForConditionalGeneration) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Dil modelleme kaybı (sonraki token tahmini için).
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).
- **past_key_values** (`Cache`, *isteğe bağlı*, `use_cache=True` geçirildiğinde veya `config.use_cache=True` olduğunda döndürülür) -- Bir [Cache](/docs/transformers/v5.23.0/tr/internal/generation_utils#transformers.Cache) örneğidir. Daha fazla ayrıntı için [kv cache kılavuzumuza](https://huggingface.co/docs/transformers/en/kv_cache) bakın.
Sıralı çözümlemeyi hızlandırmak için (bkz. `past_key_values` girdisi) kullanılabilen, önceden hesaplanmış gizli durumları (self-attention bloklarındaki anahtar ve değerler) içerir.
- **hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren ve `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `(batch_size, num_heads, sequence_length, sequence_length)` biçiminde, her katman için bir adet içeren `torch.Tensor` demeti.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
- **image_hidden_states** (`torch.Tensor`, *isteğe bağlı*) -- `(batch_size, num_images, sequence_length, hidden_size)` boyutunda bir `torch.Tensor`. Görüntü kodlayıcısı tarafından üretilen ve son gizli durum projeksiyonundan sonra modelin image_hidden_states'i.
Örnek:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> prompt = "USER: \nWhat's the content of the image? ASSISTANT:"
>>> url = "https://www.ilankelman.org/stopsigns/australia.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, text=prompt, return_tensors="pt")
>>> # Generate
>>> generate_ids = model.generate(**inputs, max_new_tokens=15)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"USER: \nWhat's the content of the image? ASSISTANT: The image features a busy city street with a stop sign prominently displayed"
```
#### get_image_features[[transformers.LlavaForConditionalGeneration.get_image_features]]
```python
get_image_features(pixel_values: Tensor, vision_feature_layer: int | list[int] | None = None, vision_feature_select_strategy: str | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/llava/modeling_llava.py#L294)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [LlavaImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakınız ([LlavaProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaProcessor), görüntü işleme için [LlavaImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaImageProcessor) kullanır).
vision_feature_layer (`Union[int, list[int]]`, *isteğe bağlı*) : Görüntü özelliğinin seçileceği katmanın indeksi. Birden fazla indeks sağlanırsa, ilgili indekslere ait görüntü özellikleri birleştirilerek görüntü özellikleri oluşturulur.
vision_feature_select_strategy (`str`, *isteğe bağlı*) : Görüntü omurgasından (vision backbone) görüntü özelliğini seçmek için kullanılan özellik seçme stratejisi. `"default"` veya `"full"` değerlerinden biri olabilir.
**Dönüş:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([LlavaConfig](/docs/transformers/v5.23.0/tr/model_doc/llava#transformers.LlavaConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- Sıralamanın ilk token'ının (sınıflandırma token'ı) son katman gizli durumu, yardımcı ön eğitim görevi için kullanılan katmanlardan geçirildikten sonraki hali. Örneğin BERT ailesi modelleri için, bu, sınıflandırma token'ının doğrusal bir katman ve tanh aktivasyon fonksiyonundan geçirildikten sonraki halini döndürür. Doğrusal katman ağırlıkları, ön eğitim sırasında bir sonraki cümle tahmini (sınıflandırma) hedefinden eğitilir.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
>>> from PIL import Image
>>> from transformers import AutoProcessor, LlavaForConditionalGeneration
>>> model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
>>> messages = [
... {
... "role": "user", "content": [
... {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
... {"type": "text", "text": "Where is the cat standing?"},
... ]
... },
... ]
>>> inputs = processor.apply_chat_template(
... messages,
... tokenize=True,
... return_dict=True,
... return_tensors="pt",
... add_generation_prompt=True
... )
>>> # Generate
>>> generate_ids = model.generate(**inputs)
>>> processor.batch_decode(generate_ids, skip_special_tokens=True)[0]
```