# Audio Spectrogram Transformer
## Tổng quan
Mô hình Audio Spectrogram Transformer được đề xuất trong [AST: Audio Spectrogram Transformer](https://huggingface.co/papers/2104.01778) bởi Yuan Gong, Yu-An Chung, James Glass. Audio Spectrogram Transformer áp dụng [Vision Transformer](vit) cho âm thanh bằng cách chuyển đổi âm thanh thành hình ảnh (spectrogram). Mô hình đạt được kết quả tiên tiến nhất cho phân loại âm thanh.
Tóm tắt từ bài báo như sau:
*Trong thập kỷ qua, mạng nơ-ron tích chập (CNN) đã được áp dụng rộng rãi như khối xây dựng chính cho các mô hình phân loại âm thanh end-to-end, nhằm học ánh xạ trực tiếp từ phổ âm thanh (spectrogram) sang các nhãn tương ứng. Để nắm bắt tốt hơn ngữ cảnh toàn cục tầm xa, một xu hướng gần đây là thêm cơ chế tự chú ý (self-attention) lên trên CNN, tạo thành mô hình lai CNN-attention. Tuy nhiên, vẫn chưa rõ liệu việc phụ thuộc vào CNN có cần thiết hay không, và liệu các mạng nơ-ron thuần túy dựa trên chú ý có đủ để đạt hiệu suất tốt trong phân loại âm thanh hay không. Trong bài báo này, chúng tôi trả lời câu hỏi đó bằng cách giới thiệu Audio Spectrogram Transformer (AST), mô hình đầu tiên không sử dụng tích chập, thuần túy dựa trên chú ý, cho phân loại âm thanh. Chúng tôi đánh giá AST trên nhiều bộ chuẩn phân loại âm thanh, nơi nó đạt được các kết quả state-of-the-art mới: 0.485 mAP trên AudioSet, độ chính xác 95,6% trên ESC-50 và độ chính xác 98,1% trên Speech Commands V2.*
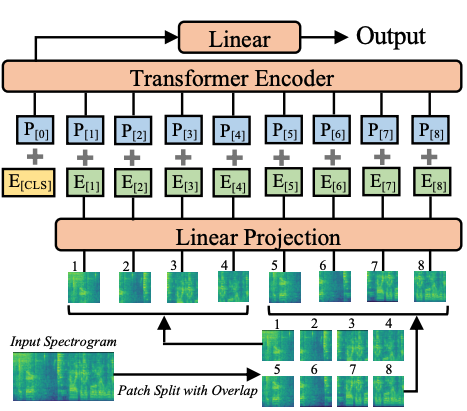 Kiến trúc Audio Spectrogram Transformer. Được trích từ bài báo gốc.
Mô hình này được đóng góp bởi [nielsr](https://huggingface.co/nielsr). Mã gốc có thể được tìm thấy [tại đây](https://github.com/YuanGongND/ast).
## Mẹo sử dụng
- Khi tinh chỉnh Audio Spectrogram Transformer (AST) trên bộ dữ liệu của riêng bạn, được khuyến nghị là nên xử lý việc chuẩn hóa đầu vào (để
chắc chắn đầu vào có trung bình là 0 và độ lệch chuẩn là 0,5). [ASTFeatureExtractor](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor) sẽ xử lý việc này. Lưu ý rằng mặc định nó sử dụng trung bình và độ lệch chuẩn của AudioSet. Bạn có thể xem [`ast/src/get_norm_stats.py`](https://github.com/YuanGongND/ast/blob/master/src/get_norm_stats.py) để biết cách các tác giả tính toán các thống kê cho một tập dữ liệu downstream.
- Lưu ý rằng AST cần tốc độ học thấp (các tác giả sử dụng tốc độ học nhỏ hơn 10 lần so với mô hình CNN của họ được đề xuất trong
[bài báo PSLA](https://huggingface.co/papers/2102.01243)) và hội tụ nhanh, vì vậy hãy tìm một tốc độ học và trình lập lịch tốc độ học phù hợp cho tác vụ của bạn.
### Sử dụng Scaled Dot Product Attention (SDPA)
PyTorch bao gồm một toán tử scaled dot-product attention (SDPA) bản địa như một phần của `torch.nn.functional`. Hàm này bao gồm một số triển khai có thể được áp dụng tùy thuộc vào đầu vào và phần cứng đang sử dụng. Xem [tài liệu chính thức](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) hoặc trang [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) để biết thêm thông tin.
SDPA được sử dụng mặc định cho `torch>=2.1.1` khi có sẵn một bản triển khai, nhưng bạn cũng có thể đặt `attn_implementation="sdpa"` trong `from_pretrained()` để yêu cầu sử dụng SDPA một cách rõ ràng.
```python
from transformers import ASTForAudioClassification
model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593", attn_implementation="sdpa", device_map="auto")
...
```
Để đạt được tốc độ tăng tốc tốt nhất, chúng tôi khuyến nghị nạp mô hình ở độ chính xác nửa (ví dụ: `torch.float16` hoặc `torch.bfloat16`).
Trên một benchmark cục bộ (A100-40GB, PyTorch 2.3.0, hệ điều hành Ubuntu 22.04) với `float32` và mô hình `MIT/ast-finetuned-audioset-10-10-0.4593`, chúng tôi đã quan sát thấy các mức tăng tốc sau trong quá trình suy luận.
| Kích thước lô | Thời gian suy luận trung bình (ms), chế độ eager | Thời gian suy luận trung bình (ms), mô hình sdpa | Tăng tốc, Sdpa / Eager (x) |
|--------------|-------------------------------------------|-------------------------------------------|------------------------------|
| 1 | 27 | 6 | 4.5 |
| 2 | 12 | 6 | 2 |
| 4 | 21 | 8 | 2.62 |
| 8 | 40 | 14 | 2.86 |
## Tài nguyên
Danh sách các tài nguyên chính thức của Hugging Face và cộng đồng (được đánh dấu bằng 🌎) để giúp bạn bắt đầu với Audio Spectrogram Transformer.
- Một notebook minh họa suy luận với AST cho phân loại âm thanh có thể được tìm thấy [tại đây](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/AST).
- [ASTForAudioClassification](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) được hỗ trợ bởi [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/audio_classification.ipynb) này.
- Xem thêm: [Phân loại âm thanh](../tasks/audio_classification).
Nếu bạn quan tâm đến việc gửi một tài nguyên để được đưa vào đây, hãy thoải mái mở một Pull Request và chúng tôi sẽ xem xét! Lý tưởng nhất là tài nguyên nên minh họa một điều gì đó mới thay vì sao chép một tài nguyên hiện có.
## ASTConfig[[transformers.ASTConfig]]
#### transformers.ASTConfig[[transformers.ASTConfig]]
```python
transformers.ASTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, patch_size: int | list[int] | tuple[int, int] = 16, qkv_bias: bool = True, frequency_stride: int = 10, time_stride: int = 10, max_length: int = 1024, num_mel_bins: int = 128)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/configuration_audio_spectrogram_transformer.py#L24)
**Tham số:**
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
attention_probs_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-12`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
patch_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `16`) : Kích thước (độ phân giải) của mỗi patch.
qkv_bias (`bool`, *tùy chọn*, mặc định là `True`) : Có thêm bias vào queries, keys và values hay không.
frequency_stride (`int`, *optional*, mặc định là 10) : Bước nhảy tần số (frequency stride) được sử dụng khi thực hiện patchify trên các spectrogram.
time_stride (`int`, *optional*, mặc định là 10) : Bước nhảy theo thời gian (temporal stride) được sử dụng khi thực hiện patchify trên các spectrogram.
max_length (`int`, *tuỳ chọn*, mặc định là 1024) : Kích thước theo chiều thời gian của các phổ âm (spectrograms).
num_mel_bins (`int`, *tuỳ chọn*, mặc định là `128`) : Số lượng đặc trưng mel được sử dụng cho mỗi khung đầu vào. Cần khớp với giá trị được dùng trong lớp `AutoFeatureExtractor`.
Đây là lớp cấu hình để lưu trữ cấu hình của một mô hình Audio Spectrogram Transformer. Nó được sử dụng để khởi tạo một mô hình Audio Spectrogram Transformer theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [MIT/ast-finetuned-audioset-10-10-0.4593](https://huggingface.co/MIT/ast-finetuned-audioset-10-10-0.4593)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/v5.23.0/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/v5.23.0/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import ASTConfig, ASTModel
>>> # Initializing a AST MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> configuration = ASTConfig()
>>> # Initializing a model (with random weights) from the MIT/ast-finetuned-audioset-10-10-0.4593 style configuration
>>> model = ASTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
#### transformers.ASTFeatureExtractor[[transformers.ASTFeatureExtractor]]
```python
transformers.ASTFeatureExtractor(feature_size = 1, sampling_rate = 16000, num_mel_bins = 128, max_length = 1024, padding_value = 0.0, do_normalize = True, mean = -4.2677393, std = 4.5689974, return_attention_mask = False, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L38)
**Tham số:**
feature_size (`int`, *tuỳ chọn*, mặc định là 1) : Kích thước chiều của các đặc trưng đã trích xuất.
sampling_rate (`int`, *optional*, mặc định là 16000) : Tốc độ lấy mẫu (sampling rate) mà các tệp âm thanh nên được số hóa, được biểu diễn bằng hertz (Hz).
num_mel_bins (`int`, *tuỳ chọn*, mặc định là 128) : Số lượng bin tần số Mel.
max_length (`int`, *tuỳ chọn*, mặc định là 1024) : Độ dài tối đa để đệm/cắt ngắn các đặc trưng đã trích xuất.
do_normalize (`bool`, *tùy chọn*, mặc định là `True`) : Có nên chuẩn hóa các đặc trưng log-Mel bằng `mean` và `std` hay không.
mean (`float`, *optional*, mặc định là -4.2677393) : Giá trị trung bình được sử dụng để chuẩn hóa các đặc trưng log-Mel. Mặc định sử dụng giá trị trung bình của AudioSet.
std (`float`, *optional*, mặc định là 4.5689974) : Giá trị độ lệch chuẩn được sử dụng để chuẩn hóa các đặc trưng log-Mel. Mặc định sử dụng độ lệch chuẩn của AudioSet.
return_attention_mask (`bool`, *tùy chọn*, mặc định là `False`) : Xác định xem [__call__()](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__) có nên trả về `attention_mask` hay không.
Tạo ra bộ trích xuất đặc trưng Audio Spectrogram Transformer (AST).
Feature extractor này kế thừa từ [SequenceFeatureExtractor](/docs/transformers/v5.23.0/vi/main_classes/feature_extractor#transformers.SequenceFeatureExtractor), bao gồm hầu hết các phương thức chính. Người dùng nên tham khảo lớp cha này để biết thêm thông tin về các phương thức đó.
Lớp này trích xuất các đặc trưng mel-filter bank từ giọng nói thô bằng TorchAudio nếu đã cài đặt, hoặc bằng numpy nếu không, sau đó đệm/cắt chúng về một độ dài cố định và chuẩn hóa chúng bằng giá trị trung bình và độ lệch chuẩn.
#### __call__[[transformers.ASTFeatureExtractor.__call__]]
```python
__call__(raw_speech: numpy.ndarray | list[float] | list[numpy.ndarray] | list[list[float]], sampling_rate: int | None = None, return_tensors: str | transformers.utils.generic.TensorType | None = None, **kwargs)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/feature_extraction_audio_spectrogram_transformer.py#L160)
**Tham số:**
raw_speech (`np.ndarray`, `list[float]`, `list[np.ndarray]`, `list[list[float]]`) : Chuỗi hoặc lô các chuỗi cần được đệm. Mỗi chuỗi có thể là một mảng numpy, một danh sách các giá trị float, một danh sách các mảng numpy hoặc một danh sách các danh sách giá trị float. Phải là âm thanh đơn kênh, không phải stereo, tức là một float duy nhất cho mỗi bước thời gian.
sampling_rate (`int`, *optional*) : Tốc độ lấy mẫu mà đầu vào `raw_speech` được lấy mẫu. Rất khuyến nghị truyền `sampling_rate` trong lời gọi forward để ngăn các lỗi âm thầm.
return_tensors (`str` hoặc [TensorType](/docs/transformers/v5.23.0/vi/internal/file_utils#transformers.TensorType), *optional*) : Nếu được đặt, sẽ trả về các tensor thay vì danh sách các số nguyên python. Các giá trị chấp nhận được là: - `'pt'`: Trả về các đối tượng `torch.Tensor` của PyTorch. - `'np'`: Trả về các đối tượng `np.ndarray` của Numpy.
Phương thức chính để tạo đặc trưng và chuẩn bị một hoặc nhiều chuỗi cho mô hình.
## ASTModel[[transformers.ASTModel]]
#### transformers.ASTModel[[transformers.ASTModel]]
```python
transformers.ASTModel(config: ASTConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L257)
**Tham số:**
config ([ASTConfig](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình Audio Spectrogram Transformer cơ bản, xuất ra các hidden-state thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ASTModel.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L273)
**Tham số:**
input_values (`torch.Tensor` có shape `(batch_size, max_length, num_mel_bins)`) : Các giá trị float là các đặc trưng mel được trích xuất từ dạng sóng âm thanh thô. Dạng sóng âm thanh thô có thể được lấy bằng cách nạp tệp âm thanh `.flac` hoặc `.wav` vào một mảng có kiểu `list[float]`, một `numpy.ndarray` hoặc một `torch.Tensor`, *ví dụ* thông qua thư viện torchcodec (`pip install torchcodec`) hoặc thư viện soundfile (`pip install soundfile`). Để chuẩn bị mảng thành `input_features`, cần sử dụng [AutoFeatureExtractor](/docs/transformers/v5.23.0/vi/model_doc/auto#transformers.AutoFeatureExtractor) để trích xuất các đặc trưng mel, đệm (padding) và chuyển đổi thành tensor có kiểu `torch.Tensor`. Xem [__call__()](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
**Trả về:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ASTConfig](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) và đầu vào.
Phương thức forward của [ASTModel](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có hình dạng `(batch_size, hidden_size)`) -- Trạng thái ẩn của lớp cuối cùng cho token đầu tiên của chuỗi (token phân loại) sau khi được xử lý thêm thông qua các lớp dùng cho tác vụ tiền huấn luyện bổ trợ. Ví dụ, đối với các mô hình thuộc họ BERT, giá trị này trả về token phân loại sau khi được xử lý qua một lớp tuyến tính và một hàm kích hoạt tanh. Trọng số của lớp tuyến tính được huấn luyện từ mục tiêu dự đoán câu tiếp theo (phân loại) trong quá trình tiền huấn luyện.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
## ASTForAudioClassification[[transformers.ASTForAudioClassification]]
#### transformers.ASTForAudioClassification[[transformers.ASTForAudioClassification]]
```python
transformers.ASTForAudioClassification(config: ASTConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L327)
**Tham số:**
config ([ASTConfig](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình Audio Spectrogram Transformer với đầu phân loại âm thanh phía trên (một lớp tuyến tính phía trên đầu ra đã được pool) ví dụ cho các bộ dữ liệu như AudioSet, Speech Commands v2.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.ASTForAudioClassification.forward]]
```python
forward(input_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/audio_spectrogram_transformer/modeling_audio_spectrogram_transformer.py#L340)
**Tham số:**
input_values (`torch.Tensor` có shape `(batch_size, max_length, num_mel_bins)`) : Các giá trị float là các đặc trưng mel được trích xuất từ dạng sóng âm thanh thô. Dạng sóng âm thanh thô có thể được lấy bằng cách nạp tệp âm thanh `.flac` hoặc `.wav` vào một mảng có kiểu `list[float]`, một `numpy.ndarray` hoặc một `torch.Tensor`, *ví dụ* thông qua thư viện torchcodec (`pip install torchcodec`) hoặc thư viện soundfile (`pip install soundfile`). Để chuẩn bị mảng thành `input_features`, cần sử dụng [AutoFeatureExtractor](/docs/transformers/v5.23.0/vi/model_doc/auto#transformers.AutoFeatureExtractor) để trích xuất các đặc trưng mel, đệm (padding) và chuyển đổi thành tensor có kiểu `torch.Tensor`. Xem [__call__()](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTFeatureExtractor.__call__)
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại/hồi quy âm thanh. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`. Nếu `config.num_labels == 1`, tổn thất hồi quy sẽ được tính toán (tổn thất bình phương trung bình), nếu `config.num_labels > 1`, tổn thất phân loại sẽ được tính toán (Cross-Entropy).
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
**Trả về:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [SequenceClassifierOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([ASTConfig](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTConfig)) và đầu vào.
Phương thức forward của [ASTForAudioClassification](/docs/transformers/v5.23.0/vi/model_doc/audio-spectrogram-transformer#transformers.ASTForAudioClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoFeatureExtractor, ASTForAudioClassification
>>> from datasets import load_dataset
>>> import torch
>>> dataset = load_dataset("hf-internal-testing/librispeech_asr_demo", "clean", split="validation")
>>> dataset = dataset.sort("id")
>>> sampling_rate = dataset.features["audio"].sampling_rate
>>> feature_extractor = AutoFeatureExtractor.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> model = ASTForAudioClassification.from_pretrained("MIT/ast-finetuned-audioset-10-10-0.4593")
>>> # audio file is decoded on the fly
>>> inputs = feature_extractor(dataset[0]["audio"]["array"], sampling_rate=sampling_rate, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.argmax(logits, dim=-1).item()
>>> predicted_label = model.config.id2label[predicted_class_ids]
>>> predicted_label
...
>>> # compute loss - target_label is e.g. "down"
>>> target_label = model.config.id2label[0]
>>> inputs["labels"] = torch.tensor([model.config.label2id[target_label]])
>>> loss = model(**inputs).loss
>>> round(loss.item(), 2)
...
```