
Transformers documentation
GLM-4.5, GLM-4.6, GLM-4.7
Model ini dipublikasikan di HF papers pada 2025-08-08 dan disumbangkan ke Hugging Face Transformers pada 2025-07-21.
GLM-4.5, GLM-4.6, GLM-4.7
Ikhtisar
Model bahasa GLM-4.7, GLM-4.6, dan GLM-4.5 menggunakan kelas ini. Implementasi di transformers tidak menyertakan lapisan MTP.
GLM-4.7
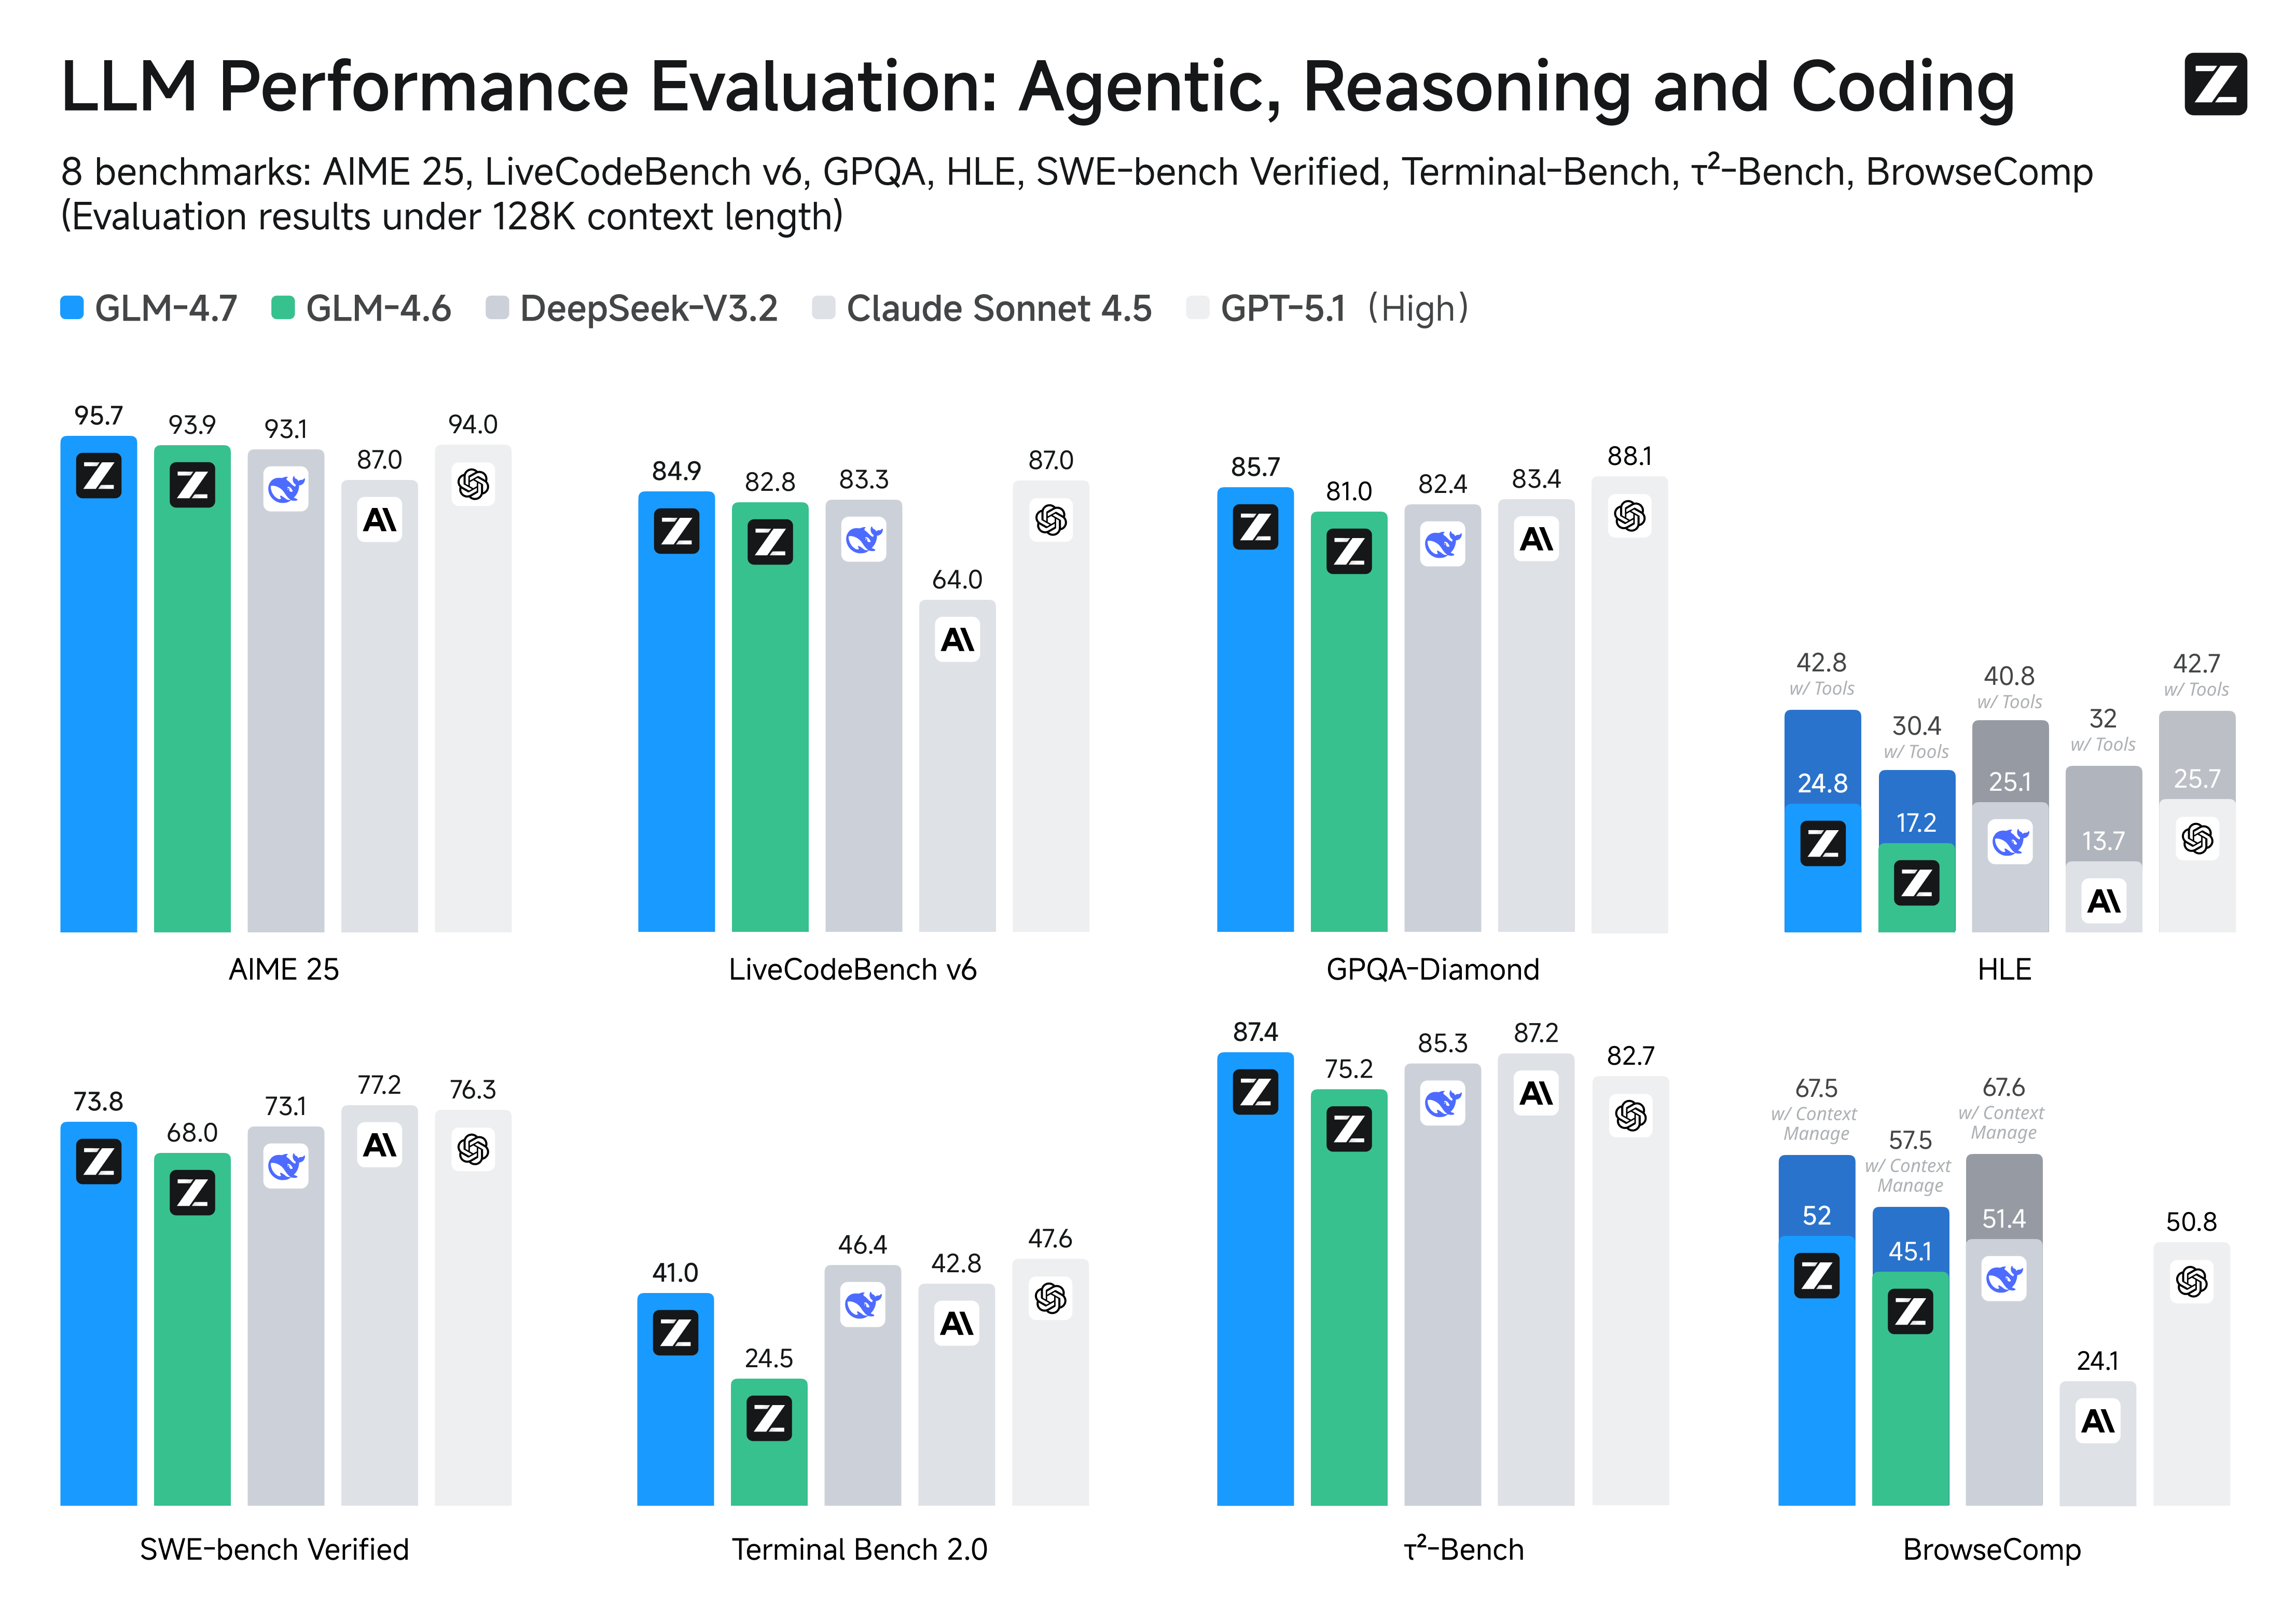
GLM-4.7, mitra coding baru Anda, segera hadir dengan fitur-fitur berikut:
- Pemrograman Inti: GLM-4.7 membawa peningkatan yang jelas, dibandingkan dengan pendahulunya GLM-4.6, dalam pemrograman agen multibahasa dan tugas berbasis terminal, termasuk (73,8%, +5,8%) pada SWE-bench, (66,7%, +12,9%) pada SWE-bench Multilingual, dan (41%, +16,5%) pada Terminal Bench 2.0. GLM-4.7 juga mendukung berpikir sebelum bertindak, dengan peningkatan signifikan pada tugas-tugas kompleks di kerangka kerja agen arus utama seperti Claude Code, Kilo Code, Cline, dan Roo Code.
- Vibe Coding: GLM-4.7 melangkah maju secara signifikan dalam meningkatkan kualitas UI. Model ini menghasilkan halaman web yang lebih bersih dan modern, serta membuat slide yang lebih menarik dengan tata letak dan ukuran yang lebih akurat.
- Penggunaan Alat: GLM-4.7 mencapai peningkatan signifikan dalam penggunaan alat. Performa yang jauh lebih baik dapat dilihat pada benchmark seperti τ^2-Bench dan pada penelusuran web melalui BrowseComp.
- Penalaran Kompleks: GLM-4.7 memberikan peningkatan signifikan pada kemampuan matematika dan penalaran, mencapai (42,8%, +12,4%) pada benchmark HLE (Humanity’s Last Exam) dibandingkan dengan GLM-4.6.
Secara lebih umum, peningkatan signifikan juga akan terlihat dalam banyak skenario lain, seperti percakapan, penulisan kreatif, dan skenario bermain peran.
Pemikiran Berselang & Pemikiran yang Dipertahankan
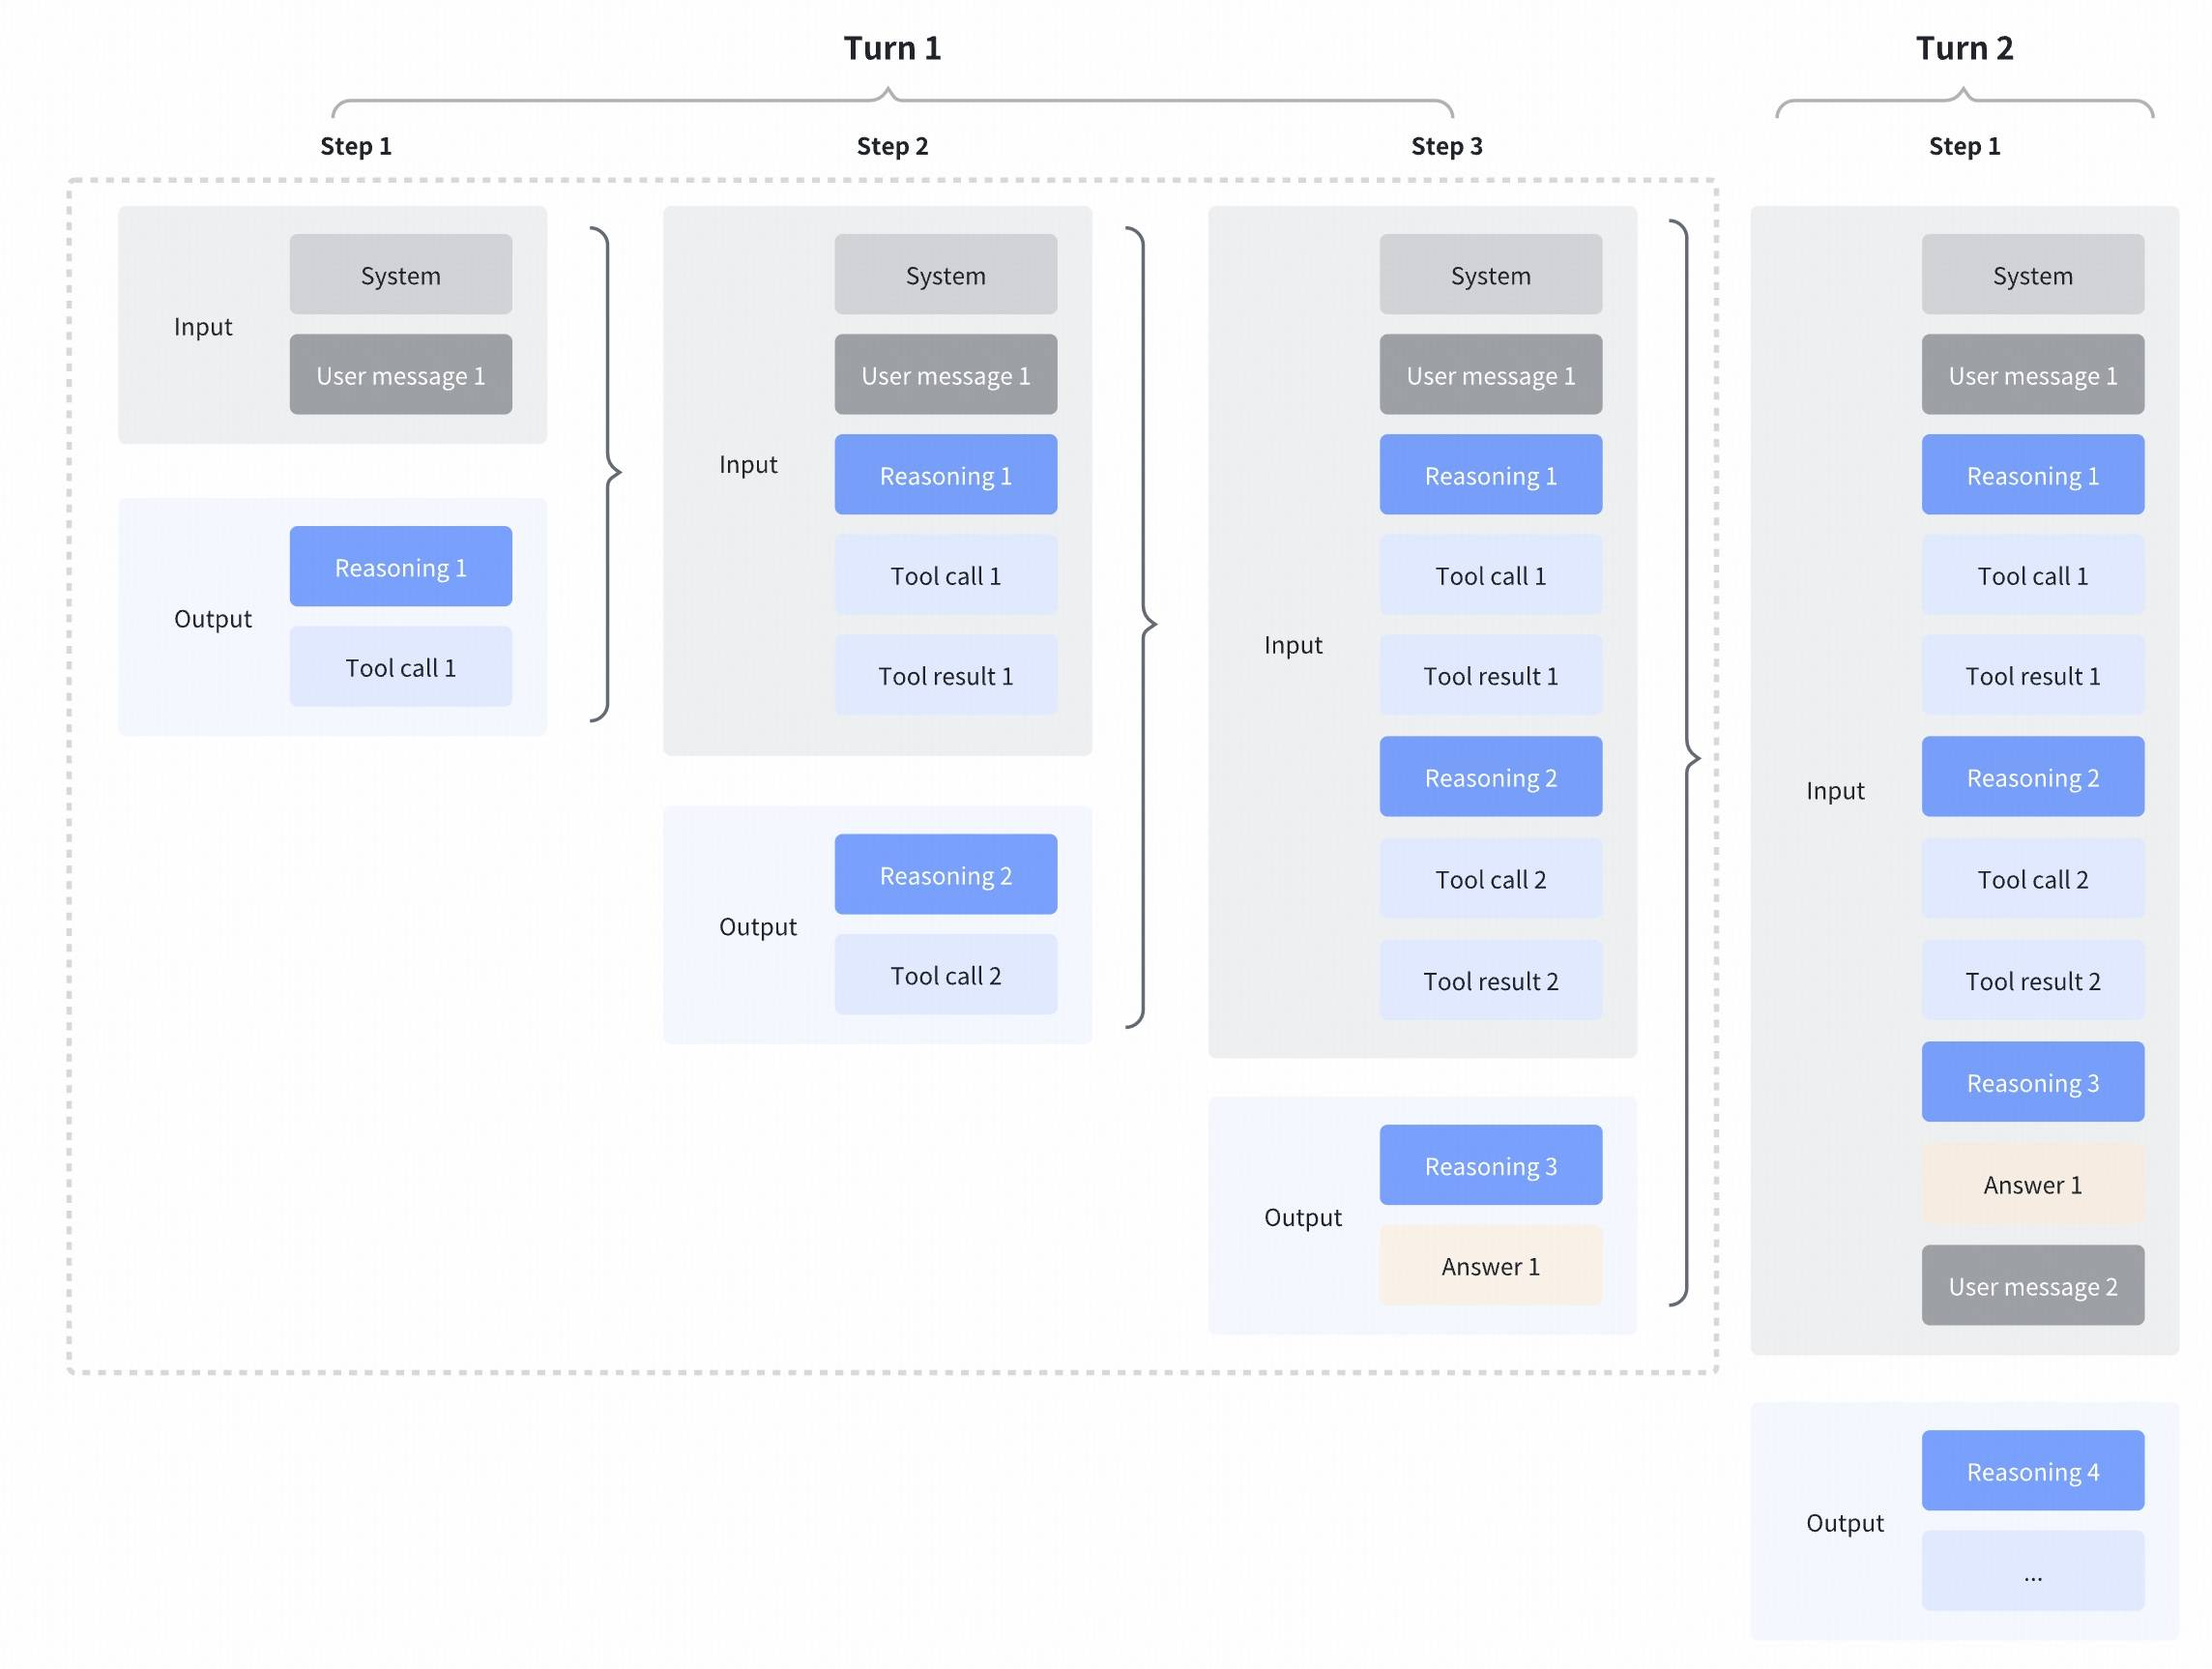
GLM-4.7 semakin meningkatkan Interleaved Thinking (fitur yang diperkenalkan sejak GLM-4.5) dan memperkenalkan Preserved Thinking serta Turn-level Thinking. Dengan berpikir di antara aksi dan tetap konsisten di setiap giliran, tugas-tugas kompleks menjadi lebih stabil dan lebih mudah dikendalikan:
- Pemikiran Bergantian: Model berpikir sebelum setiap respons dan pemanggilan alat, meningkatkan kepatuhan instruksi dan kualitas generasi.
- Pemikiran yang Dipertahankan: Dalam skenario agen coding, model secara otomatis mempertahankan semua blok pemikiran di sepanjang percakapan multi-turn, dengan memanfaatkan penalaran yang sudah ada alih-alih menurunkannya ulang dari awal. Hal ini mengurangi hilangnya informasi dan inkonsistensi, serta sangat cocok untuk tugas-tugas kompleks dengan cakupan waktu yang panjang.
- Pemikiran per Tingkat Giliran: Model mendukung kontrol per giliran atas penalaran dalam sesi—nonaktifkan pemikiran untuk permintaan ringan guna mengurangi latensi/biaya, aktifkan untuk tugas kompleks guna meningkatkan akurasi dan stabilitas.
Detail lebih lanjut: https://docs.z.ai/guides/capabilities/thinking-mode
Untuk hasil evaluasi, studi kasus, dan detail teknis lainnya, silakan kunjungi blog teknis GLM-4.7.
GLM-4.6
Dibandingkan dengan GLM-4.5, GLM-4.6 membawa beberapa peningkatan utama:
- Jendela konteks lebih panjang: Jendela konteks telah diperluas dari 128K menjadi 200K token, memungkinkan model untuk menangani tugas agentic yang lebih kompleks.
- Kinerja pemrograman yang unggul: Model ini mencapai skor yang lebih tinggi pada benchmark kode dan menunjukkan kinerja dunia nyata yang lebih baik dalam aplikasi seperti Claude Code、Cline、Roo Code dan Kilo Code, termasuk peningkatan dalam menghasilkan halaman front-end yang secara visual lebih rapi.
- Penalaran lanjutan: GLM-4.6 menunjukkan peningkatan yang jelas dalam kinerja penalaran dan mendukung penggunaan alat selama inferensi, sehingga menghasilkan kemampuan keseluruhan yang lebih kuat.
- Agen yang lebih mumpuni: GLM-4.6 menunjukkan performa yang lebih kuat dalam agen berbasis penggunaan alat dan pencarian, serta terintegrasi secara lebih efektif dalam kerangka kerja agen.
- Penulisan yang disempurnakan: Lebih selaras dengan preferensi manusia dalam hal gaya dan keterbacaan, serta berperilaku lebih alami dalam skenario role-playing.
Kami mengevaluasi GLM-4.6 di delapan benchmark publik yang mencakup agen, penalaran, dan pemrograman. Hasilnya menunjukkan peningkatan yang jelas dibandingkan GLM-4.5, dengan GLM-4.6 juga mempertahankan keunggulan kompetitif dibandingkan model-model terkemuka domestik dan internasional seperti DeepSeek-V3.1-Terminus dan Claude Sonnet 4.
Untuk hasil evaluasi, studi kasus, dan detail teknis lainnya, silakan kunjungi blog teknis GLM-4.6.
GLM-4.5
Model seri GLM-4.5 adalah model fondasi yang dirancang untuk agen cerdas, dan varian MoE didokumentasikan di sini sebagai Glm4Moe.
GLM-4.5 memiliki total 355 miliar parameter dengan 32 miliar parameter aktif, sedangkan GLM-4.5-Air mengadopsi desain yang lebih ringkas dengan total 106 miliar parameter dan 12 miliar parameter aktif. Model GLM-4.5 menyatukan kemampuan penalaran, pemrograman, dan agen cerdas untuk memenuhi tuntutan kompleks dari aplikasi agen cerdas.
Baik GLM-4.5 maupun GLM-4.5-Air adalah model penalaran hibrida yang menyediakan dua mode: mode berpikir untuk penalaran kompleks dan penggunaan alat, serta mode non-berpikir untuk respons langsung.
Kami telah membuka sumber model dasar, model penalaran hibrida, dan versi FP8 dari model penalaran hibrida untuk GLM-4.5 dan GLM-4.5-Air. Model-model ini dirilis di bawah lisensi open-source MIT dan dapat digunakan secara komersial maupun untuk pengembangan sekunder.
Seperti yang ditunjukkan dalam evaluasi komprehensif kami di 12 benchmark standar industri, GLM-4.5 mencapai kinerja luar biasa dengan skor 63.2, menempati peringkat ke-3 di antara semua model proprietary dan open-source. Secara khusus, GLM-4.5-Air memberikan hasil yang kompetitif di 59.8 sambil mempertahankan efisiensi yang unggul.
Untuk hasil evaluasi, studi kasus, dan detail teknis lainnya, silakan kunjungi laporan teknis atau blog teknis kami.
Kode model, parser alat, dan parser penalaran dapat ditemukan dalam implementasi transformers, vLLM, dan SGLang.
Glm4MoeConfig
kelas transformers.Glm4MoeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 151552hidden_size: int = 4096intermediate_size: int = 10944num_hidden_layers: int = 46num_attention_heads: int = 96num_key_value_heads: int = 8hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truetie_word_embeddings: bool = Falserope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0moe_intermediate_size: int = 1408num_experts_per_tok: int = 8output_router_logits: bool = Falsen_shared_experts: int = 1n_routed_experts: int = 128routed_scaling_factor: float = 1.0n_group: int = 1topk_group: int = 1first_k_dense_replace: int = 1norm_topk_prob: bool = Trueuse_qk_norm: bool = Falsebos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepad_token_id: int | None = Nonenum_mtp_layers: int = 1 )
Parameter
- vocab_size (
int, opsional, default151552) — Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan olehinput_ids. - hidden_size (
int, opsional, default4096) — Dimensi dari representasi tersembunyi. - intermediate_size (
int, opsional, default10944) — Dimensi representasi MLP. - num_hidden_layers (
int, opsional, default46) — Jumlah lapisan tersembunyi dalam decoder Transformer. - num_attention_heads (
int, opsional, default96) — Jumlah attention head untuk setiap lapisan attention di decoder Transformer. - num_key_value_heads (
int, opsional, default8) — Ini adalah jumlah key_value heads yang harus digunakan untuk mengimplementasikan Grouped Query Attention. Jikanum_key_value_heads=num_attention_heads, model akan menggunakan Multi Head Attention (MHA), jikanum_key_value_heads=1model akan menggunakan Multi Query Attention (MQA), selain itu GQA yang digunakan. Saat mengkonversi checkpoint multi-head menjadi checkpoint GQA, setiap group key dan value head harus dibangun dengan meanpooling semua head asli di dalam grup tersebut. Untuk detail lebih lanjut, lihat paper ini. Jika tidak ditentukan, akan default kenum_attention_heads. - hidden_act (
str, opsional, defaultnyasilu) — Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya,"gelu","relu","silu", dan sebagainya. - max_position_embeddings (
int, opsional, default131072) — Panjang maksimum urutan yang mungkin digunakan dengan model ini. - initializer_range (
float, opsional, defaultnya0.02) — Standar deviasi dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot. - rms_norm_eps (
float, opsional, defaultnya1e-05) — Epsilon yang digunakan oleh lapisan normalisasi rms. - use_cache (
bool, opsional, defaultnyaTrue) — Apakah model harus mengembalikan perhatian kunci/nilai terakhir (tidak digunakan oleh semua model). Hanya relevan jikaconfig.is_decoder=Trueatau ketika model adalah model generatif yang hanya decoder. - tie_word_embeddings (
bool, opsional, defaultFalse) — Apakah akan mengikat bobot embedding sesuai dengan pemetaantied_weights_keysmodel. - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], opsional) — Kamus yang berisi parameter konfigurasi untuk embedding RoPE. Kamus tersebut harus berisi nilai untukrope_thetadan secara opsional parameter yang digunakan untuk penskalaan jika Anda ingin menggunakan RoPE denganmax_position_embeddingsyang lebih panjang. - attention_bias (
bool, opsional, defaultFalse) — Apakah akan menggunakan bias pada lapisan proyeksi query, key, value, dan output selama self-attention. - attention_dropout (
Union[float, int], opsional, default0.0) — Rasio dropout untuk probabilitas perhatian. - moe_intermediate_size (
int, opsional, default1408) — Ukuran intermediate dari MLP expert yang di-rutekan. - num_experts_per_tok (
int, opsional, default8) — Jumlah expert yang akan menerima setiap token. Ini adalah nilai top-k untuk routing pemilihan token. - output_router_logits (
bool, opsional, defaultFalse) — Apakah logits router harus dikembalikan oleh model. Mengaktifkan ini juga akan memungkinkan model untuk mengoutput loss tambahan, termasuk load balancing loss dan router z-loss. - n_shared_experts (
int, opsional, defaultnya1) — Jumlah expert yang dibagikan. - n_routed_experts (
int, opsional, default128) — Jumlah expert yang dirutekan. - routed_scaling_factor (
float, opsional, default1.0) — Faktor penskalaan untuk pakar yang di-rutekan. - n_group (
int, opsional, default 1) — Jumlah grup untuk pakar yang dirutekan. - topk_group (
int, opsional, default1) — Jumlah grup yang dipilih untuk setiap token (untuk setiap token, memastikan pakar yang dipilih hanya berada di dalamtopk_groupgrup). - first_k_dense_replace (
int, opsional, default 1) — Jumlah lapisan dense pada lapisan dangkal (embed->dense->dense->…->dense->moe->moe…->lm_head). --k lapisan dense—/ - norm_topk_prob (
bool, opsional, defaultTrue) — Apakah akan menormalisasi bobot dari para ahli yang dirutekan. - use_qk_norm (
bool, opsional, defaultFalse) — Apakah akan menggunakan normalisasi query-key dalam perhatian (attention). - bos_token_id (
int, opsional) — ID token yang digunakan untuk awal aliran (beginning-of-stream) dalam kosakata. - eos_token_id (
Union[int, list[int]], opsional) — ID token yang digunakan untuk akhir aliran dalam kosakata. - pad_token_id (
int, opsional) — ID token yang digunakan untuk padding dalam kosakata. - num_mtp_layers (
int, opsional, default 1) — Jumlah modul Multi-Token Prediction (MTP) yang tersedia untuk ditambahkan setelah model transformer dasar. Ketika0, model berperilaku sebagai decoder standar. Ketika>0, setiap modul tambahan dapat memprediksi satu token masa depan tambahan pada saat inferensi (speculative decoding melaluigenerate(..., use_mtp=True)).
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari Glm4MoeModel. Kelas ini digunakan untuk membuat instans model Glm4 Moe berdasarkan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari zai-org/GLM-4.5
Objek konfigurasi mewarisi dari PreTrainedConfig dan dapat digunakan untuk mengontrol output model. Baca dokumentasi dari PreTrainedConfig untuk informasi lebih lanjut.
Contoh:
>>> from transformers import Glm4MoeModel, Glm4MoeConfig

>>> # Initializing a Glm4Moe style configuration
>>> configuration = Glm4MoeConfig()

>>> # Initializing a model from the GLM-4-MOE-100B-A10B style configuration
>>> model = Glm4MoeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Glm4MoeModel
kelas transformers.Glm4MoeModel
< source >( config: Glm4MoeConfig )
Parameter
- config (Glm4MoeConfig) — Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode from_pretrained() untuk memuat bobot model.
Model Glm4 Moe polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari PreTrainedModel. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran embedding input, memangkas kepala, dll.)
Model ini juga merupakan subclass dari torch.nn.Module PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Parameter
- input_ids (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default.Indeks dapat diperoleh menggunakan AutoTokenizer. Lihat PreTrainedTokenizer.encode() dan PreTrainedTokenizer.call() untuk detailnya.
- attention_mask (
torch.Tensordengan bentuk(batch_size, sequence_length), opsional) — Mask untuk menghindari eksekusi attention pada indeks token padding. Nilai mask dipilih dari[0, 1]:- 1 untuk token yang tidak dimasker,
- 0 untuk token yang dimasker.
- position_ids (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Indeks posisi token dari setiap urutan input dalam position embeddings. Dipilih dalam rentang[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opsional) — Hidden-states yang sudah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan untuk mempercepat decoding berurutan. Ini biasanya terdiri daripast_key_valuesyang dikembalikan oleh model pada tahap decoding sebelumnya, ketikause_cache=Trueatauconfig.use_cache=True.Hanya instance Cache yang diizinkan sebagai input, lihat panduan kv cache kami. Jika tidak ada
past_key_valuesyang diteruskan, DynamicCache akan diinisialisasi secara default.Model akan menghasilkan format cache yang sama dengan yang diberikan sebagai input.
Jika
past_key_valuesdigunakan, pengguna diharapkan hanya memasukkaninput_idsyang belum diproses (yang tidak memiliki state past key value yang diberikan ke model ini) dengan bentuk(batch_size, unprocessed_length)alih-alih semuainput_idsdengan bentuk(batch_size, sequence_length). - inputs_embeds (
torch.Tensordengan bentuk(batch_size, sequence_length, hidden_size), opsional) — Secara opsional, alih-alih meneruskaninput_ids, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Hal ini berguna jika Anda ingin memiliki kendali lebih atas cara mengonversi indeksinput_idsmenjadi vektor terkait, dibandingkan dengan matriks pencarian penanaman internal model. - use_cache (
bool, opsional) — Jika diset keTrue, state kunci-nilaipast_key_valuesakan dikembalikan dan dapat digunakan untuk mempercepat decoding (lihatpast_key_values).
Mengembalikan
MoeModelOutputWithPast atau tuple(torch.Tensor)
MoeModelOutputWithPast atau tuple dari
torch.Tensor (jika return_dict=False diteruskan atau ketika config.return_dict=False) yang terdiri dari berbagai
elemen tergantung pada konfigurasi (Glm4MoeConfig) dan input.
Metode forward dari Glm4MoeModel menimpa metode khusus __call__.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance
Modulesetelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
last_hidden_state (
torch.Tensordengan bentuk(batch_size, sequence_length, hidden_size)) — Urutan hidden-states pada keluaran lapisan terakhir model.past_key_values (
Cache, opsional, dikembalikan saatuse_cache=Truedilewatkan atau saatconfig.use_cache=True) — Ini adalah instance Cache. Untuk detail lebih lanjut, lihat panduan kv cache kami.Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention, dan secara opsional jika
config.is_encoder_decoder=Truedi blok cross-attention) yang dapat digunakan (lihat inputpast_key_values) untuk mempercepat decoding berurutan.hidden_states (
tuple(torch.Tensor), opsional, dikembalikan saatoutput_hidden_states=Truedilewatkan atau saatconfig.output_hidden_states=True) — Tuple daritorch.Tensor(satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk(batch_size, sequence_length, hidden_size).Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
attentions (
tuple(torch.Tensor), opsional, dikembalikan saatoutput_attentions=Truedilewatkan atau saatconfig.output_attentions=True) — Tuple daritorch.Tensor(satu untuk setiap layer) dengan bentuk(batch_size, num_heads, sequence_length, sequence_length).Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala perhatian diri (self-attention).
router_logits (
tuple(torch.Tensor), opsional, dikembalikan ketikaoutput_router_probs=Truedanconfig.add_router_probs=Truediteruskan atau ketikaconfig.output_router_probs=True) — Tuple daritorch.Tensor(satu untuk setiap layer) dengan bentuk(batch_size, sequence_length, num_experts).Logit router mentah (setelah softmax) yang dihitung oleh router MoE; istilah-istilah ini digunakan untuk menghitung auxiliary loss pada model Mixture of Experts.
Glm4MoeForCausalLM
kelas transformers.Glm4MoeForCausalLM
< source >( config: Glm4MoeConfig )
Parameter
- config (Glm4MoeConfig) — Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode from_pretrained() untuk memuat bobot model.
Model Glm4 Moe untuk pemodelan bahasa kausal.
Model ini mewarisi dari PreTrainedModel. Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran embedding input, memangkas kepala, dll.)
Model ini juga merupakan subclass dari torch.nn.Module PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Parameter
- input_ids (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default.Indeks dapat diperoleh menggunakan AutoTokenizer. Lihat PreTrainedTokenizer.encode() dan PreTrainedTokenizer.call() untuk detailnya.
- attention_mask (
torch.Tensordengan bentuk(batch_size, sequence_length), opsional) — Mask untuk menghindari eksekusi attention pada indeks token padding. Nilai mask dipilih dari[0, 1]:- 1 untuk token yang tidak dimasker,
- 0 untuk token yang dimasker.
- position_ids (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Indeks posisi token dari setiap urutan input dalam position embeddings. Dipilih dalam rentang[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opsional) — Hidden-states yang sudah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan untuk mempercepat decoding berurutan. Ini biasanya terdiri daripast_key_valuesyang dikembalikan oleh model pada tahap decoding sebelumnya, ketikause_cache=Trueatauconfig.use_cache=True.Hanya instance Cache yang diizinkan sebagai input, lihat panduan kv cache kami. Jika tidak ada
past_key_valuesyang diteruskan, DynamicCache akan diinisialisasi secara default.Model akan menghasilkan format cache yang sama dengan yang diberikan sebagai input.
Jika
past_key_valuesdigunakan, pengguna diharapkan hanya memasukkaninput_idsyang belum diproses (yang tidak memiliki state past key value yang diberikan ke model ini) dengan bentuk(batch_size, unprocessed_length)alih-alih semuainput_idsdengan bentuk(batch_size, sequence_length). - inputs_embeds (
torch.Tensordengan bentuk(batch_size, sequence_length, hidden_size), opsional) — Secara opsional, alih-alih meneruskaninput_ids, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Hal ini berguna jika Anda ingin memiliki kendali lebih atas cara mengonversi indeksinput_idsmenjadi vektor terkait, dibandingkan dengan matriks pencarian penanaman internal model. - labels (
torch.LongTensordengan bentuk(batch_size, sequence_length), opsional) — Label untuk menghitung kerugian pemodelan bahasa yang disamarkan (masked language modeling). Indeks harus berada dalam[0, ..., config.vocab_size]atau -100 (lihat docstringinput_ids). Token dengan indeks yang disetel ke-100diabaikan (disamarkan), kerugian hanya dihitung untuk token dengan label dalam[0, ..., config.vocab_size]. - use_cache (
bool, opsional) — Jika diset keTrue, state kunci-nilaipast_key_valuesakan dikembalikan dan dapat digunakan untuk mempercepat decoding (lihatpast_key_values). - logits_to_keep (
Union[int, torch.Tensor], opsional, default0) — Jika berupaint, hitung logits untuklogits_to_keeptoken terakhir. Jika0, hitung logits untuk semuainput_ids(kasus khusus). Hanya logits token terakhir yang diperlukan untuk generasi, dan menghitungnya hanya untuk token tersebut dapat menghemat memori, yang menjadi cukup signifikan untuk urutan panjang atau ukuran kosakata besar. Jika berupatorch.Tensor, harus 1D yang sesuai dengan indeks yang akan dipertahankan pada dimensi panjang urutan. Ini berguna saat menggunakan format tensor terpadu (satu dimensi untuk batch dan panjang urutan).
Mengembalikan
MoeCausalLMOutputWithPast atau tuple(torch.Tensor)
MoeCausalLMOutputWithPast atau tuple dari
torch.Tensor (jika return_dict=False dilewatkan atau ketika config.return_dict=False) yang terdiri dari berbagai
elemen tergantung pada konfigurasi (Glm4MoeConfig) dan input.
Metode forward dari Glm4MoeForCausalLM menimpa metode khusus __call__.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance
Modulesetelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
loss (
torch.Tensordengan bentuk(1,), opsional, dikembalikan saatlabelsdisediakan) — Loss pemodelan bahasa (untuk prediksi token berikutnya).logits (
torch.Tensordengan bentuk(batch_size, sequence_length, config.vocab_size)) — Skor prediksi dari kepala pemodelan bahasa (skor untuk setiap token kosakata sebelum SoftMax).aux_loss (
torch.Tensor, opsional, dikembalikan ketikaoutput_router_logits=Truedilewatkan atau ketikaconfig.output_router_logits=True, dan model melatih router-nya dengan loss penyeimbangan beban) — Loss bantu penyeimbangan beban untuk modul sparse. Model yang menyeimbangkan pakar mereka dengan bias router sebagai gantinya (DeepSeek-V3 dan arsitektur yang diturunkan darinya) mengembalikanNonedi sini sambil tetap mengembalikanrouter_logits.router_logits (
tuple(torch.Tensor), opsional, dikembalikan ketikaoutput_router_logits=Truediteruskan atau ketikaconfig.output_router_logits=True) — Tuple daritorch.Tensor(satu untuk setiap lapisan sparse) dengan bentuk(batch_size * sequence_length, num_experts).Logit router mentah yang dihitung oleh router MoE. Logit ini dapat digunakan untuk menghitung kerugian penyeimbangan beban (load-balancing loss) atau untuk memeriksa bagaimana token didistribusikan ke para ahli (experts).
past_key_values (
Cache, opsional, dikembalikan saatuse_cache=Truedilewatkan atau saatconfig.use_cache=True) — Ini adalah instance Cache. Untuk detail lebih lanjut, lihat panduan kv cache kami.Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention) yang dapat digunakan (lihat input
past_key_values) untuk mempercepat decoding berurutan.hidden_states (
tuple(torch.Tensor), opsional, dikembalikan saatoutput_hidden_states=Truedilewatkan atau saatconfig.output_hidden_states=True) — Tuple daritorch.Tensor(satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk(batch_size, sequence_length, hidden_size).Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
attentions (
tuple(torch.Tensor), opsional, dikembalikan saatoutput_attentions=Truedilewatkan atau saatconfig.output_attentions=True) — Tuple daritorch.Tensor(satu untuk setiap layer) dengan bentuk(batch_size, num_heads, sequence_length, sequence_length).Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala perhatian diri (self-attention).
Contoh:
>>> from transformers import AutoTokenizer, Glm4MoeForCausalLM

>>> model = Glm4MoeForCausalLM.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."