
Transformers documentation
GLM-4.5, GLM-4.6, GLM-4.7
Este modelo foi publicado em HF papers em 2025-08-08 e contribuído para Hugging Face Transformers em 2025-07-21.
GLM-4.5, GLM-4.6, GLM-4.7
Visão geral
Os modelos de linguagem GLM-4.7, GLM-4.6 e GLM-4.5 utilizam esta classe. A implementação no transformers não inclui uma camada MTP.
GLM-4.7
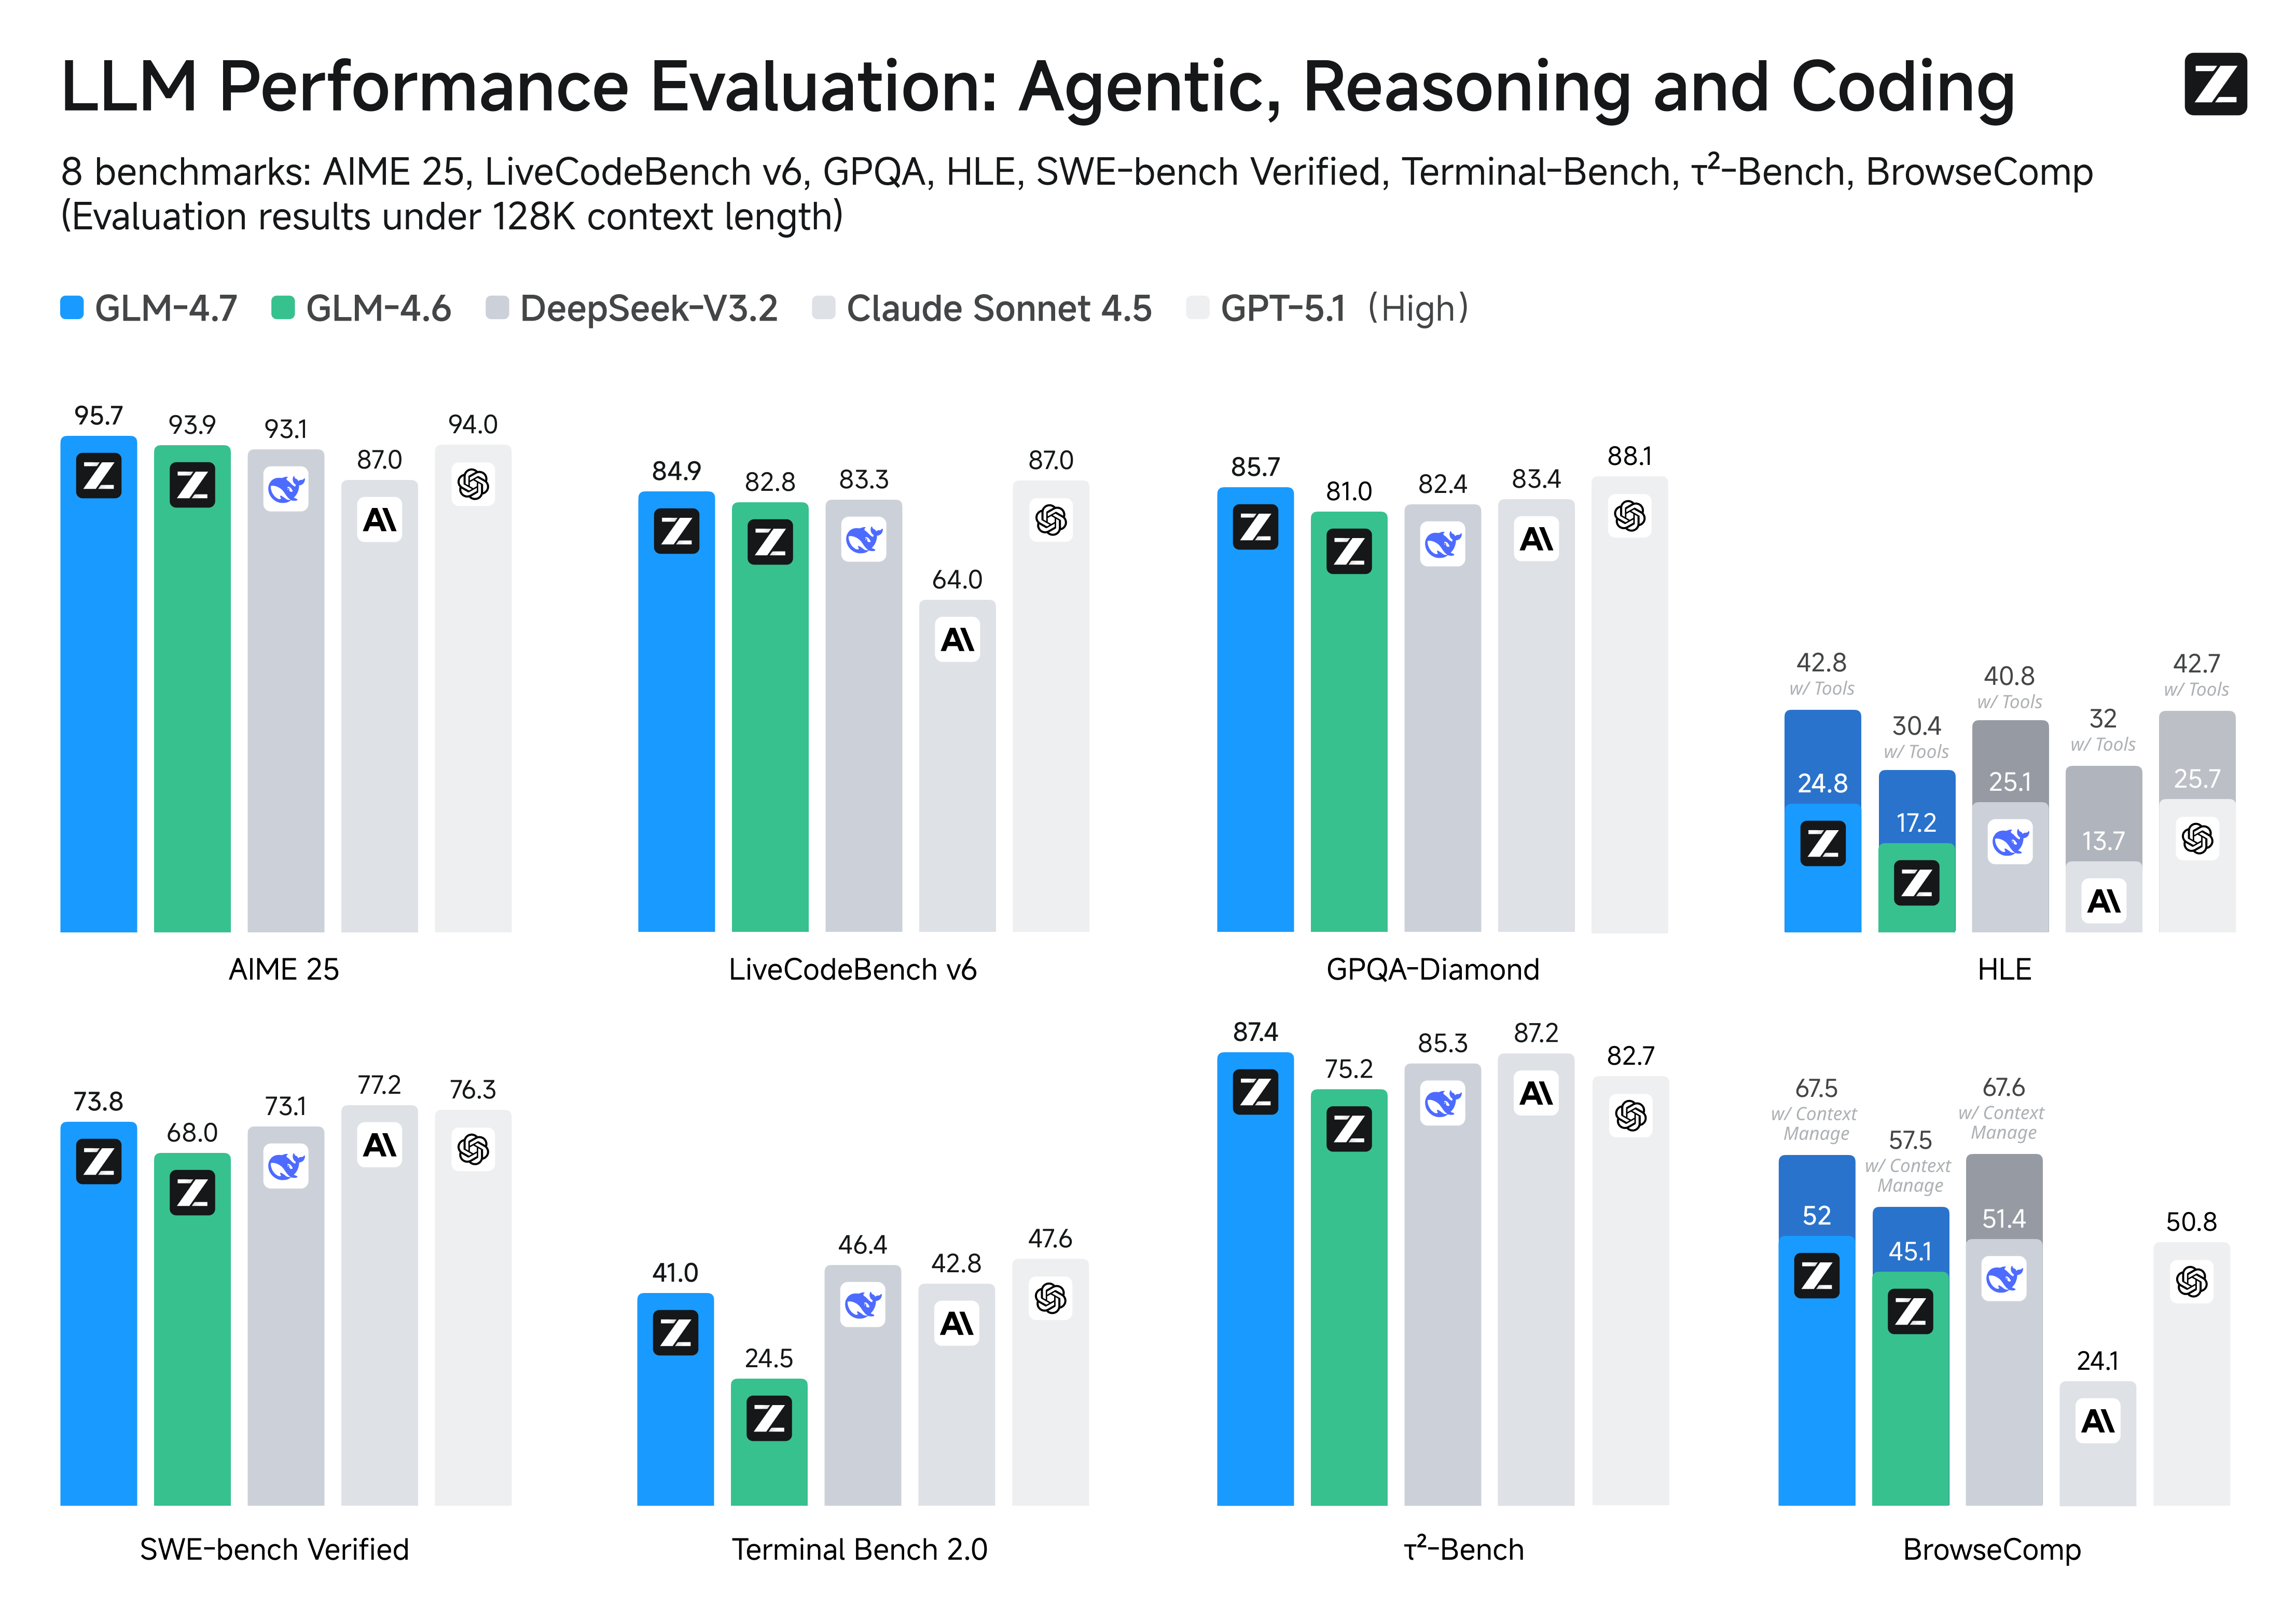
GLM-4.7, seu novo parceiro de programação, chega com os seguintes recursos:
- Coding principal: o GLM-4.7 apresenta ganhos claros, em comparação com seu antecessor GLM-4.6, em coding agêntico multilíngue e em tarefas baseadas em terminal, incluindo (73,8%, +5,8%) no SWE-bench, (66,7%, +12,9%) no SWE-bench Multilingual e (41%, +16,5%) no Terminal Bench 2.0. O GLM-4.7 também suporta o raciocínio antes da ação, com melhorias significativas em tarefas complexas em frameworks de agentes mainstream, como Claude Code, Kilo Code, Cline e Roo Code.
- Vibe Coding: o GLM-4.7 dá um grande passo em frente na melhoria da qualidade da interface do usuário. Ele produz páginas da web mais limpas e modernas e gera slides com aparência mais atraente, com layout e dimensionamento mais precisos.
- Uso de ferramentas: o GLM-4.7 apresenta melhorias significativas no uso de ferramentas. Desempenhos muito melhores podem ser observados em benchmarks como τ^2-Bench e na navegação na web via BrowseComp.
- Raciocínio complexo: o GLM-4.7 oferece um aumento significativo nas capacidades matemáticas e de raciocínio, alcançando (42,8%, +12,4%) no benchmark HLE (Humanity’s Last Exam) em comparação com o GLM-4.6.
De forma mais geral, também se observaria melhorias significativas em muitos outros cenários, como chat, escrita criativa e cenários de role-play.
Pensamento Intercalado & Pensamento Preservado
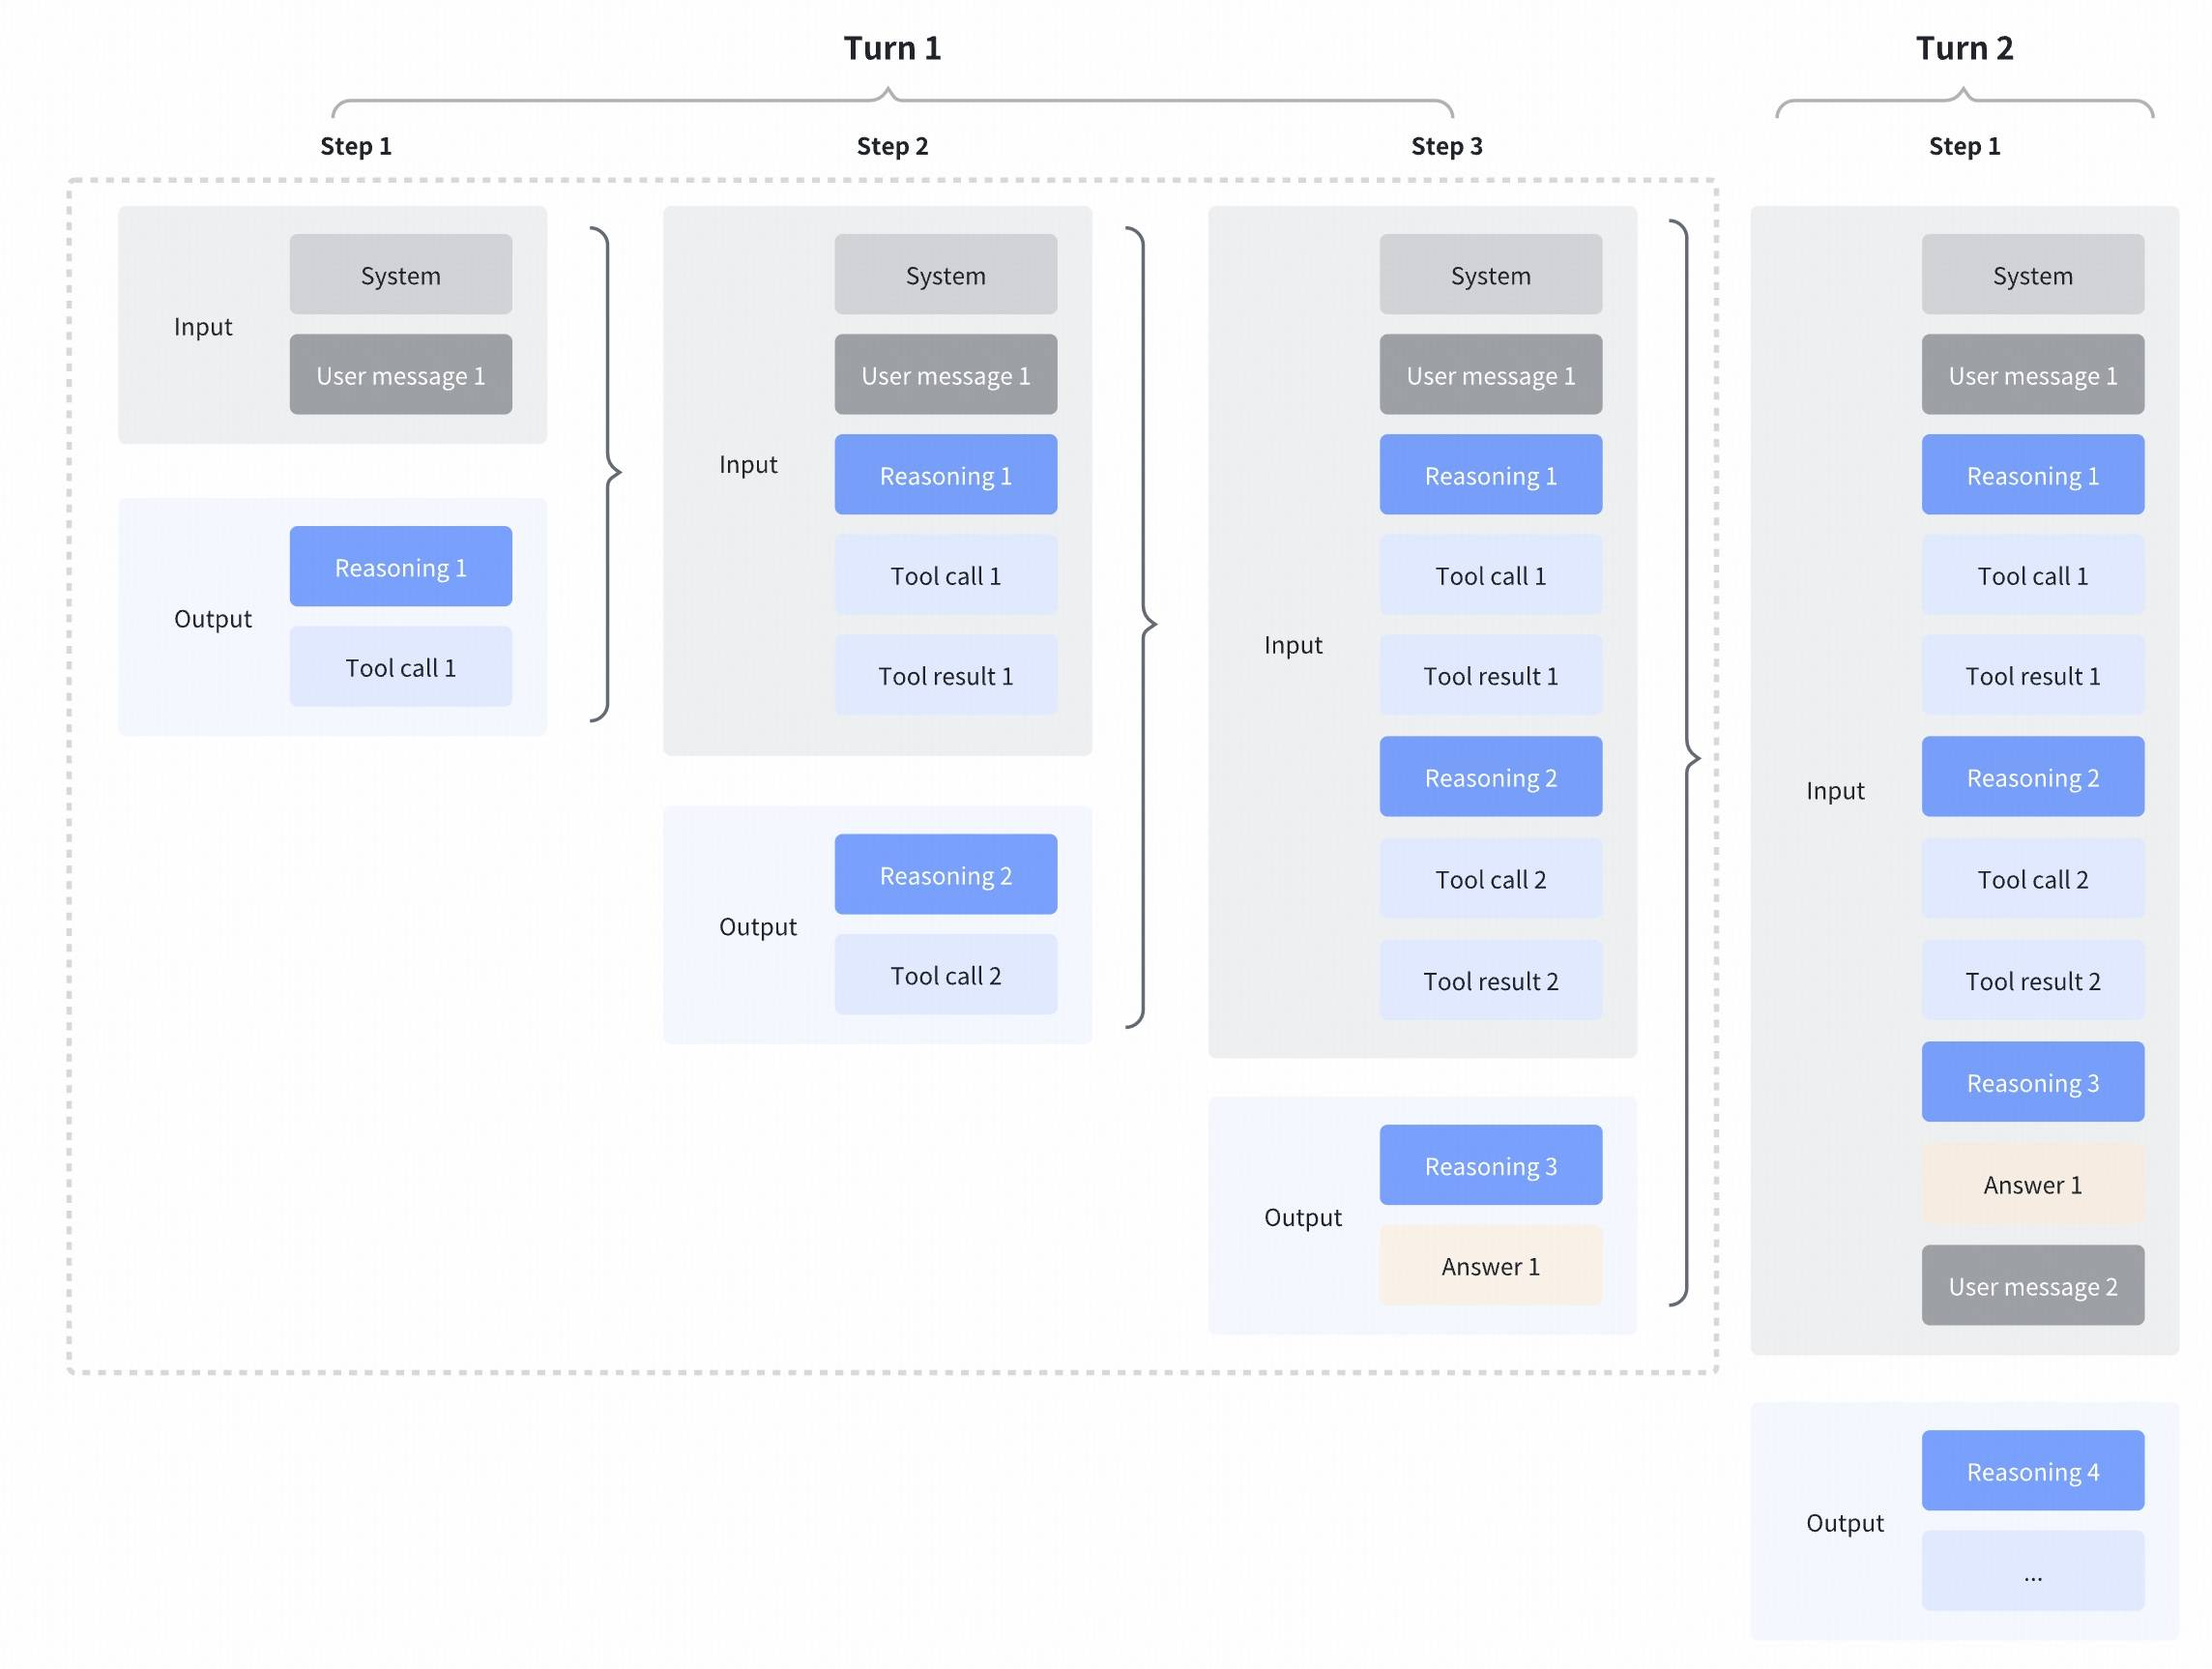
O GLM-4.7 aprimora ainda mais o Interleaved Thinking (um recurso introduzido a partir do GLM-4.5) e apresenta o Preserved Thinking e o Turn-level Thinking. Ao pensar entre as ações e manter consistência entre as rodadas, ele torna as tarefas complexas mais estáveis e mais controláveis:
- Pensamento Intercalado: O modelo pensa antes de cada resposta e chamada de ferramenta, melhorando o seguimento de instruções e a qualidade da geração.
- Pensamento Preservado: Em cenários de agentes de codificação, o modelo retém automaticamente todos os blocos de pensamento ao longo de conversas com múltiplas rodadas, reutilizando o raciocínio existente em vez de rederivá-lo do zero. Isso reduz a perda de informação e inconsistências, sendo adequado para tarefas complexas de longo prazo.
- Pensamento por turno: O modelo oferece controle por turno sobre o raciocínio dentro de uma sessão — desative o pensamento para solicitações leves para reduzir latência/custo e ative-o para tarefas complexas para melhorar a precisão e a estabilidade.
Mais detalhes: https://docs.z.ai/guides/capabilities/thinking-mode
Para mais resultados de avaliação, casos de uso e detalhes técnicos, visite o blog técnico do GLM-4.7.
GLM-4.6
Em comparação com o GLM-4.5, o GLM-4.6 traz várias melhorias importantes:
- Janela de contexto maior: A janela de contexto foi expandida de 128K para 200K tokens, permitindo que o modelo lide com tarefas agênticas mais complexas.
- Desempenho superior em codificação: O modelo atinge pontuações mais altas em benchmarks de código e demonstra um desempenho melhor no mundo real em aplicações como Claude Code, Cline, Roo Code e Kilo Code, incluindo melhorias na geração de páginas front-end visualmente refinadas.
- Raciocínio avançado: O GLM-4.6 apresenta uma melhora clara no desempenho de raciocínio e suporta o uso de ferramentas durante a inferência, resultando em uma capacidade geral mais robusta.
- Agentes mais capazes: O GLM-4.6 apresenta desempenho superior em agentes que utilizam ferramentas e baseados em busca, e se integra de forma mais eficaz a frameworks de agentes.
- Escrita refinada: Alinha-se melhor às preferências humanas em estilo e legibilidade, e atua de forma mais natural em cenários de interpretação de papéis.
Avaliamos o GLM-4.6 em oito benchmarks públicos que abrangem agentes, raciocínio e codificação. Os resultados mostram ganhos claros em relação ao GLM-4.5, com o GLM-4.6 também mantendo vantagens competitivas em relação a modelos líderes nacionais e internacionais, como DeepSeek-V3.1-Terminus e Claude Sonnet 4.
Para mais resultados de avaliação, casos de uso e detalhes técnicos, visite o blog técnico do GLM-4.6.
GLM-4.5
Os modelos da série GLM-4.5 são modelos de fundação projetados para agentes inteligentes; as variantes MoE estão documentadas aqui como Glm4Moe.
O GLM-4.5 possui 355 bilhões de parâmetros no total, com 32 bilhões de parâmetros ativos, enquanto o GLM-4.5-Air adota um design mais compacto, com 106 bilhões de parâmetros no total e 12 bilhões de parâmetros ativos. Os modelos GLM-4.5 unificam capacidades de raciocínio, codificação e agentes inteligentes para atender às demandas complexas de aplicações de agentes inteligentes.
Tanto o GLM-4.5 quanto o GLM-4.5-Air são modelos híbridos de raciocínio que oferecem dois modos: o modo de raciocínio, para raciocínio complexo e uso de ferramentas, e o modo sem raciocínio, para respostas imediatas.
Tornamos públicos os modelos base, os modelos de raciocínio híbrido e as versões FP8 dos modelos de raciocínio híbrido para o GLM-4.5 e o GLM-4.5-Air. Eles são liberados sob a licença de código aberto MIT e podem ser usados comercialmente e para desenvolvimento secundário.
Como demonstrado em nossa avaliação abrangente em 12 benchmarks padrão da indústria, o GLM-4.5 atinge um desempenho excepcional com uma pontuação de 63.2, ocupando a 3ª posição entre todos os modelos proprietários e de código aberto. Notavelmente, o GLM-4.5-Air entrega resultados competitivos em 59.8, mantendo uma eficiência superior.
Para mais resultados de avaliação, casos de uso e detalhes técnicos, visite nosso relatório técnico ou blog técnico.
O código do modelo, o parser de ferramentas e o parser de raciocínio podem ser encontrados na implementação de transformers, vLLM e SGLang.
Glm4MoeConfig
classe transformers.Glm4MoeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 151552hidden_size: int = 4096intermediate_size: int = 10944num_hidden_layers: int = 46num_attention_heads: int = 96num_key_value_heads: int = 8hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truetie_word_embeddings: bool = Falserope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0moe_intermediate_size: int = 1408num_experts_per_tok: int = 8output_router_logits: bool = Falsen_shared_experts: int = 1n_routed_experts: int = 128routed_scaling_factor: float = 1.0n_group: int = 1topk_group: int = 1first_k_dense_replace: int = 1norm_topk_prob: bool = Trueuse_qk_norm: bool = Falsebos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonepad_token_id: int | None = Nonenum_mtp_layers: int = 1 )
Parâmetros
- vocab_size (
int, opcional, padrão151552) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - hidden_size (
int, opcional, padrão4096) — Dimensão das representações ocultas. - intermediate_size (
int, opcional, padrão10944) — Dimensão das representações do MLP. - num_hidden_layers (
int, opcional, padrão46) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão96) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_key_value_heads (
int, opcional, padrão8) — Este é o número de cabeças de key_value que devem ser usadas para implementar Grouped Query Attention. Senum_key_value_heads=num_attention_heads, o modelo usará Multi Head Attention (MHA); senum_key_value_heads=1, o modelo usará Multi Query Attention (MQA); caso contrário, será usado GQA. Ao converter um checkpoint multi-head para um checkpoint GQA, cada grupo de cabeças de chave e valor deve ser construído por meio do meanpooling de todas as cabeças originais dentro desse grupo. Para mais detalhes, consulte este artigo. Se não for especificado, o valor padrão seránum_attention_heads. - hidden_act (
str, opcional, padrãosilu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - max_position_embeddings (
int, opcional, padrão131072) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - rms_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização rms. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - tie_word_embeddings (
bool, opcional, padrãoFalse) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo. - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], opcional) — Dicionário contendo os parâmetros de configuração para os embeddings RoPE. O dicionário deve conter um valor pararope_thetae, opcionalmente, parâmetros usados para escalonamento, caso você queira usar RoPE commax_position_embeddingsmaiores. - attention_bias (
bool, opcional, padrãoFalse) — Indica se deve ser usado um viés nas camadas de projeção de query, key, value e output durante a autoatenção. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - moe_intermediate_size (
int, opcional, padrão1408) — Tamanho intermediário dos MLPs dos especialistas roteados. - num_experts_per_tok (
int, opcional, padrão8) — Número de especialistas para os quais cada token deve ser roteado. Este é o valor top-k para o roteamento de escolha de token. - output_router_logits (
bool, opcional, padrãoFalse) — Indica se os logits do roteador devem ser retornados pelo modelo. Ativar essa opção também permitirá que o modelo saída a perda auxiliar, incluindo a perda de balanceamento de carga e a perda z do roteador. - n_shared_experts (
int, opcional, padrão1) — Número de especialistas compartilhados. - n_routed_experts (
int, opcional, padrão128) — Número de especialistas roteados. - routed_scaling_factor (
float, opcional, padrão1.0) — Fator de escala dos especialistas roteados. - n_group (
int, opcional, padrão 1) — Número de grupos para especialistas roteados. - topk_group (
int, opcional, padrão1) — Número de grupos selecionados para cada token (para cada token, garantindo que os especialistas selecionados estejam apenas dentro detopk_groupgrupos). - first_k_dense_replace (
int, opcional, padrão 1) — Número de camadas densas nas camadas mais rasas (embed->dense->dense->…->dense->moe->moe…->lm_head). --k camadas densas—/ - norm_topk_prob (
bool, opcional, padrãoTrue) — Indica se as pesos dos especialistas roteados devem ser normalizados. - use_qk_norm (
bool, opcional, padrãoFalse) — Se deve usar normalização de query-key na atenção. - bos_token_id (
int, opcional) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional) — ID do token usado para o fim do fluxo no vocabulário. - pad_token_id (
int, opcional) — ID do token usado para preenchimento no vocabulário. - num_mtp_layers (
int, opcional, padrão 1) — Número de módulos de Multi-Token Prediction (MTP) disponíveis para adicionar após o modelo transformer base. Quando0, o modelo se comporta como um decodificador padrão. Quando>0, cada módulo extra pode prever um token futuro adicional no momento da inferência (decodificação especulativa viagenerate(..., use_mtp=True)).
Esta é a classe de configuração para armazenar a configuração de um Glm4MoeModel. Ela é usada para instanciar um modelo Glm4 Moe de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do zai-org/GLM-4.5
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import Glm4MoeModel, Glm4MoeConfig

>>> # Initializing a Glm4Moe style configuration
>>> configuration = Glm4MoeConfig()

>>> # Initializing a model from the GLM-4-MOE-100B-A10B style configuration
>>> model = Glm4MoeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Glm4MoeModel
classe transformers.Glm4MoeModel
< source >( config: Glm4MoeConfig )
Parâmetros
- config (Glm4MoeConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Glm4 Moe puro, que gera estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values).
Retorna
MoeModelOutputWithPast ou tuple(torch.Tensor)
Um MoeModelOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Glm4MoeConfig) e das entradas.
O método forward do Glm4MoeModel substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se
config.is_encoder_decoder=True, nos blocos de atenção cruzada) que podem ser usados (veja a entradapast_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
router_logits (
tuple(torch.Tensor), opcional, retornado quandooutput_router_probs=Trueeconfig.add_router_probs=Truesão passados ou quandoconfig.output_router_probs=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, sequence_length, num_experts).Logits brutos do roteador (pós-softmax) calculados pelos roteadores MoE; esses termos são usados para calcular a perda auxiliar em modelos Mixture of Experts.
Glm4MoeForCausalLM
classe transformers.Glm4MoeForCausalLM
< source >( config: Glm4MoeConfig )
Parâmetros
- config (Glm4MoeConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O Modelo Glm4 Moe para modelagem de linguagem causal.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[0, ..., config.vocab_size]ou ser -100 (veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size]. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - logits_to_keep (
Union[int, torch.Tensor], opcional, padrão0) — Se for umint, calcula os logits para os últimoslogits_to_keeptokens. Se for0, calcula os logits para todos osinput_ids(caso especial). Apenas os logits do último token são necessários para a geração, e calculá-los apenas para esse token pode economizar memória, o que se torna bastante significativo para sequências longas ou tamanho de vocabulário grande. Se for umtorch.Tensor, deve ser 1D, correspondendo aos índices a serem mantidos na dimensão de comprimento da sequência. Isso é útil ao usar o formato de tensor empacotado (uma única dimensão para lote e comprimento da sequência).
Retorna
MoeCausalLMOutputWithPast ou tuple(torch.Tensor)
Um MoeCausalLMOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (Glm4MoeConfig) e das entradas.
O método forward de Glm4MoeForCausalLM sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).aux_loss (
torch.Tensor, opcional, retornado quandooutput_router_logits=Trueé passado ou quandoconfig.output_router_logits=True, e o modelo treina seu roteador com uma perda de balanceamento de carga) — Perda auxiliar de balanceamento de carga para os módulos esparsos. Modelos que equilibram seus especialistas com um viés de roteador em vez disso (DeepSeek-V3 e as arquiteturas derivadas dele) retornamNoneaqui, mas ainda retornamrouter_logits.router_logits (
tuple(torch.Tensor), opcional, retornado quandooutput_router_logits=Trueé passado ou quandoconfig.output_router_logits=True) — Tupla detorch.Tensor(um para cada camada esparsa) com forma(batch_size * sequence_length, num_experts).Logits brutos do roteador calculados pelos roteadores MoE. Podem ser usados para calcular uma perda de balanceamento de carga ou para inspecionar como os tokens são distribuídos entre os especialistas.
past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from transformers import AutoTokenizer, Glm4MoeForCausalLM

>>> model = Glm4MoeForCausalLM.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm4_moe/Glm4Moe-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."