
Transformers documentation
Быстрый старт
Быстрый старт
Transformers разработан так, чтобы быть быстрым и удобным в использовании, что позволяет каждому начать изучение или создание моделей на основе трансформеров.
Количество пользовательских абстракций ограничено всего тремя классами для создания модели и двумя API для вывода или обучения. В этом быстром старте вы познакомитесь с ключевыми возможностями Transformers и узнаете, как:
- загрузить предобученную модель
- выполнить инференс с помощью Pipeline
- дообучить модель с помощью Trainer
Настройка
Для начала рекомендуем создать аккаунт Hugging Face. С его помощью вы можете размещать и получать доступ к моделям, наборам данных и Spaces с контролем версий на Hub Hugging Face — платформе для совместной работы, поиска и создания.
Создайте User Access Token и войдите в свой аккаунт.
Вставьте ваш User Access Token в notebook_login, когда система попросит вас войти.
from huggingface_hub import notebook_login

notebook_login()
Убедитесь, что установлен пакет huggingface_hub[cli], и выполните команду ниже. При запросе введите свой User Access Token для входа.
hf auth login
Установите PyTorch.
# remove ! if installing from the CLI
!pip install torch
Затем установите актуальную версию Transformers и некоторые дополнительные библиотеки из экосистемы Hugging Face для работы с наборами данных и моделями компьютерного зрения, оценки обучения и оптимизации обучения для больших моделей.
# remove ! if installing from the CLI
!pip install -U transformers datasets evaluate accelerate timm
Навыки агента
Hugging Face Skills обучают вашего кодинг-агента работе с Transformers. Вместо того чтобы самостоятельно писать скрипт обучения, попросите агента дообучить модель компьютерного зрения и позвольте скиллу направить его действия.
/plugin marketplace add huggingface/skills
/plugin install hf-cli@huggingface/skills
codex plugin marketplace add huggingface/skills
Затем выполните /plugins в Codex и установите навык из репозитория huggingface/skills.
См. руководство по установке для получения информации о других поддерживаемых платформах, таких как Cursor и Gemini.
После установки навыка включите его в инструкции для вашего кодинг-агента.
Use the HF Trainer skill to fine-tune RT-DETRv2 on [Lekim89/sportsmot](https://huggingface.co/datasets/Lekim89/sportsmot) for basketball player tracking.Предобученные модели
Каждая предобученная модель наследуется от трёх базовых классов.
| Класс | Описание |
|---|---|
| PreTrainedConfig | Файл, в котором указаны атрибуты модели, такие как количество головок внимания или размер словаря. |
| PreTrainedModel | Модель (или архитектура), определяемая атрибутами модели из файла конфигурации. Предобученная модель возвращает только необработанные скрытые состояния. Для конкретной задачи используйте соответствующую головку модели, чтобы преобразовать необработанные скрытые состояния в осмысленный результат (например, LlamaModel и LlamaForCausalLM). |
| Предобработчик | Класс для преобразования исходных данных (текст, изображения, аудио, мультимодальные данные) в числовые входные данные модели. Например, PreTrainedTokenizer преобразует текст в тензоры, а ImageProcessingMixin — пиксели в тензоры. |
Мы рекомендуем использовать API AutoClass для загрузки моделей и препроцессоров, поскольку он автоматически определяет подходящую архитектуру для каждой задачи и фреймворка машинного обучения на основе имени или пути к предобученным весам и файлу конфигурации.
Используйте from_pretrained(), чтобы загрузить веса и файл конфигурации с Hub в класс модели и препроцессора.
При загрузке модели настройте следующие параметры, чтобы обеспечить оптимальную загрузку.
device_map="auto"автоматически распределяет веса модели, начиная с самого быстрого устройства.dtype="auto"инициализирует веса модели непосредственно в том типе данных, в котором они хранятся, что позволяет избежать двойной загрузки весов (по умолчанию PyTorch загружает веса в типеtorch.float32).
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("meta-llama/Llama-2-7b-hf", dtype="auto", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
Токенизируйте текст с помощью токенизатора и верните тензоры PyTorch. Перед запуском инференса переместите токенизированные входные данные на то же устройство, на котором находится модель, чтобы модель могла их обработать.
model_inputs = tokenizer(["The secret to baking a good cake is "], return_tensors="pt").to(model.device)Модель готова для вывода или обучения.
Для вывода передайте токенизированные входные данные в generate(), чтобы сгенерировать текст. Затем декодируйте идентификаторы токенов обратно в текст с помощью batch_decode().
generated_ids = model.generate(**model_inputs, max_length=30)
tokenizer.batch_decode(generated_ids)[0]
'<s> The secret to baking a good cake is 100% in the preparation. There are so many recipes out there,'
Перейдите сразу к разделу Trainer, чтобы узнать, как дообучить модель.
Пайплайн
Класс Pipeline — самый удобный способ выполнять инференс с помощью предобученной модели. Он поддерживает множество задач, таких как генерация текста, сегментация изображений, автоматическое распознавание речи, ответ на вопросы по документам и другие.
Список доступных задач см. в справочнике API Pipeline.
Создайте объект Pipeline и выберите задачу. По умолчанию Pipeline скачивает и кэширует предобученную модель по умолчанию для указанной задачи. Передайте имя модели в параметр model, чтобы выбрать конкретную модель.
Используйте Accelerator для автоматического обнаружения доступного ускорителя для инференса.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipe = pipeline("text-generation", model="meta-llama/Llama-2-7b-hf", device=device)
Запрос Pipeline с некоторым начальным текстом для генерации дополнительного текста.
pipe("The secret to baking a good cake is ", max_length=50)
[{'generated_text': 'The secret to baking a good cake is 100% in the batter. The secret to a great cake is the icing.\nThis is why we’ve created the best buttercream frosting reci'}]
Используйте Accelerator для автоматического обнаружения доступного ускорителя для инференса.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("image-segmentation", model="facebook/detr-resnet-50-panoptic", device=device)
Передайте изображение — URL или локальный путь к файлу — в Pipeline.
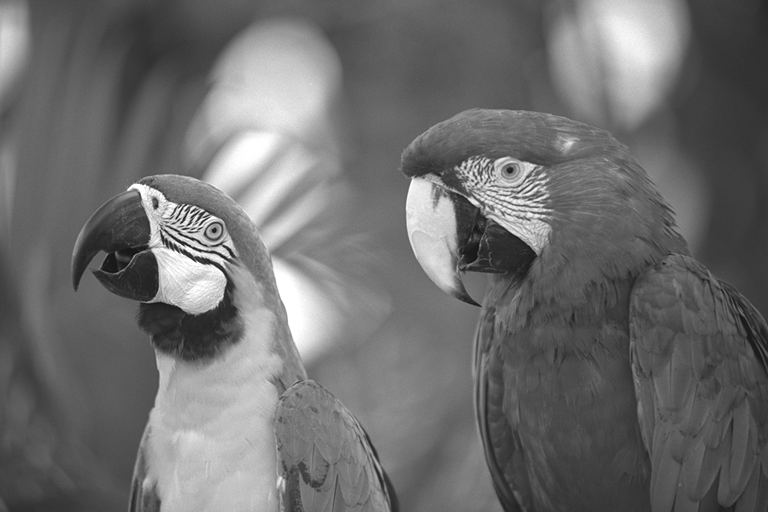
segments = pipeline("https://huggingface.co/datasets/Narsil/image_dummy/raw/main/parrots.png")
segments[0]["label"]
'bird'
segments[1]["label"]
'bird'
Используйте Accelerator для автоматического обнаружения доступного ускорителя для инференса.
from transformers import pipeline
from accelerate import Accelerator

device = Accelerator().device

pipeline = pipeline("automatic-speech-recognition", model="openai/whisper-large-v3", device=device)
Передайте аудиофайл в Pipeline.
pipeline("https://huggingface.co/datasets/Narsil/asr_dummy/resolve/main/1.flac")
{'text': ' He hoped there would be stew for dinner, turnips and carrots and bruised potatoes and fat mutton pieces to be ladled out in thick, peppered flour-fatten sauce.'}
Trainer
Trainer — это полный цикл обучения и оценки для моделей PyTorch. Он абстрагирует от значительной части шаблонного кода, который обычно приходится писать при ручной реализации цикла обучения, что позволяет быстрее приступить к обучению и сосредоточиться на архитектурных решениях. Для создания пакетов данных из набора данных вам понадобятся только модель, датасет, препроцессор и data collator.
Используйте класс TrainingArguments для настройки процесса обучения. Он предоставляет множество опций для обучения, оценки и других задач. Экспериментируйте с гиперпараметрами и функциями обучения, такими как размер батча, скорость обучения, смешанная точность, torch.compile и другие, чтобы удовлетворить ваши потребности. Вы также можете использовать параметры обучения по умолчанию, чтобы быстро получить базовый результат.
Загрузите модель, токенизатор и набор данных для обучения.
from transformers import AutoModelForSequenceClassification, AutoTokenizer
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained("distilbert/distilbert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("distilbert/distilbert-base-uncased")
dataset = load_dataset("cornell-movie-review-data/rotten_tomatoes")
Создайте функцию для токенизации текста и преобразования его в тензоры PyTorch. Примените эту функцию ко всему набору данных с помощью метода map.
def tokenize_dataset(dataset):
    return tokenizer(dataset["text"])
dataset = dataset.map(tokenize_dataset, batched=True)
Загрузите коллабор данных для создания батчей данных и передайте ему токенизатор.
from transformers import DataCollatorWithPadding

data_collator = DataCollatorWithPadding(tokenizer=tokenizer)
Далее настройте TrainingArguments с функциями обучения и гиперпараметрами.
from transformers import TrainingArguments

training_args = TrainingArguments(
    output_dir="distilbert-rotten-tomatoes",
    learning_rate=2e-5,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=2,
    push_to_hub=True,
)
Наконец, передайте все эти отдельные компоненты в Trainer и вызовите train(), чтобы запустить обучение.
from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["test"],
    processing_class=tokenizer,
    data_collator=data_collator,
)

trainer.train()
Опубликуйте вашу модель и токенизатор на Hub с помощью push_to_hub().
trainer.push_to_hub()
Поздравляем, вы только что обучили свою первую модель с помощью Transformers!
Дальнейшие шаги
Теперь, когда вы лучше понимаете, что такое Transformers и что он предлагает, самое время продолжать изучение и углубляться в то, что вам интереснее всего.
- Базовые классы: Узнайте больше о классах конфигурации, моделей и процессоров. Это поможет вам понять, как создавать и настраивать модели, предобрабатывать различные типы входных данных (аудио, изображения, мультимодальные) и как делиться своей моделью.
- Вывод: изучите Pipeline подробнее, а также вывод и общение с LLM, агентами и способы оптимизации вывода с использованием вашего фреймворка машинного обучения и оборудования.
- Обучение: Изучите Trainer подробнее, а также распределённое обучение и оптимизацию обучения на конкретном оборудовании.
- Квантование: сократите требования к памяти и хранилищу с помощью квантования и ускорьте инференс, представляя веса меньшим числом бит.
- Ресурсы: Ищете пошаговые инструкции по обучению и инференсу модели для конкретной задачи? Загляните в рецепты по задачам!