
TRL documentation
TRL - Transformers 강화 학습

TRL - Transformers 강화 학습
TRL은 Supervised Fine-Tuning (SFT), Group Relative Policy Optimization (GRPO), Direct Preference Optimization (DPO), Reward Modeling 등의 방법으로 transformer 언어 모델을 학습할 수 있는 도구 세트를 제공하는 풀 스택 라이브러리입니다. 해당 라이브러리는 🤗 transformers와 통합되어 있습니다.
🎉 새 소식
⚡ AsyncGRPOTrainer가 이제 안정화되었습니다: AsyncGRPOTrainer가 안정된 API로 승격되었습니다. 생성과 학습을 분리하여 GRPO를 훨씬 더 빠르게 실행합니다. vLLM 서버가 롤아웃을 스트리밍하는 동안 트레이너가 모델을 업데이트합니다.
분류
아래는 성숙도와 방법 유형별로 정리된 TRL 트레이너 개요입니다.
실험적
TRL 관련 모델, 데이터셋, 데모를 TRL Hugging Face 조직에서도 탐색할 수 있습니다.
학습
🤗 smol course에서 TRL 및 기타 라이브러리를 활용한 포스트 트레이닝을 학습해 보세요.
목차
문서는 다음 섹션으로 구성됩니다:
- 시작하기: 설치 및 빠른 시작 가이드.
- 개념 가이드: 데이터셋 형식, 학습 FAQ, 로그 이해하기.
- 사용 가이드: 메모리 사용량 줄이기, 학습 속도 높이기, 학습 분산하기 등
- 통합: DeepSpeed, PEFT 등
- 예시: 예시 개요, 커뮤니티 튜토리얼 등
- API: trainers, utils 등
블로그 게시물
2026년 5월 27일에 게시됨
Hub 버킷으로 1조 개 매개변수 배포: TRL의 Delta Weight Sync

2026년 3월 31일에 게시됨
TRL v1: 해당 분야가 자체 가정을 무효화해도 견고함을 유지하는 후학습 라이브러리
2026년 3월 10일에 게시됨
토큰의 흐름을 유지하다: 16개의 오픈소스 RL 라이브러리에서 배운 것
2026년 3월 9일에 게시됨
Ulysses Sequence Parallelism: 백만 토큰 컨텍스트로 학습
2025년 10월 23일 게시
함께 구축하는 오픈 에이전트 생태계: OpenEnv 소개
2025년 8월 7일에 게시됨
TRL에서 Vision Language Model 정렬 ⚡️
2025년 6월 3일에 게시됨
NO GPU left behind: TRL에서 Co-located vLLM으로 효율성 해방
2025년 5월 25일에 게시됨
🐯 Liger GRPO와 TRL의 만남
2025년 1월 28일에 게시됨
Open-R1: DeepSeek-R1의 완전한 오픈 재현
2024년 7월 10일에 게시됨
TRL을 활용한 비전 언어 모델의 선호도 최적화
2024년 6월 12일에 게시됨
RLHF에 RL을 다시 적용하기
2024년 1월 10일에 게시됨
Unsloth와 🤗 TRL로 LLM Fine-tuning을 2배 빠르게
2023년 9월 29일에 게시됨
TRL을 사용하여 DDPO로 Stable Diffusion 모델을 Fine-tune
2023년 8월 8일에 게시됨
DPO를 사용하여 Llama 2를 Fine-tune
2023년 4월 5일에 게시됨
StackLLaMA: RLHF로 LLaMA를 학습하는 실전 가이드
2023년 3월 9일에 게시됨
24GB 소비자용 GPU에서 RLHF로 20B LLM 파인튜닝
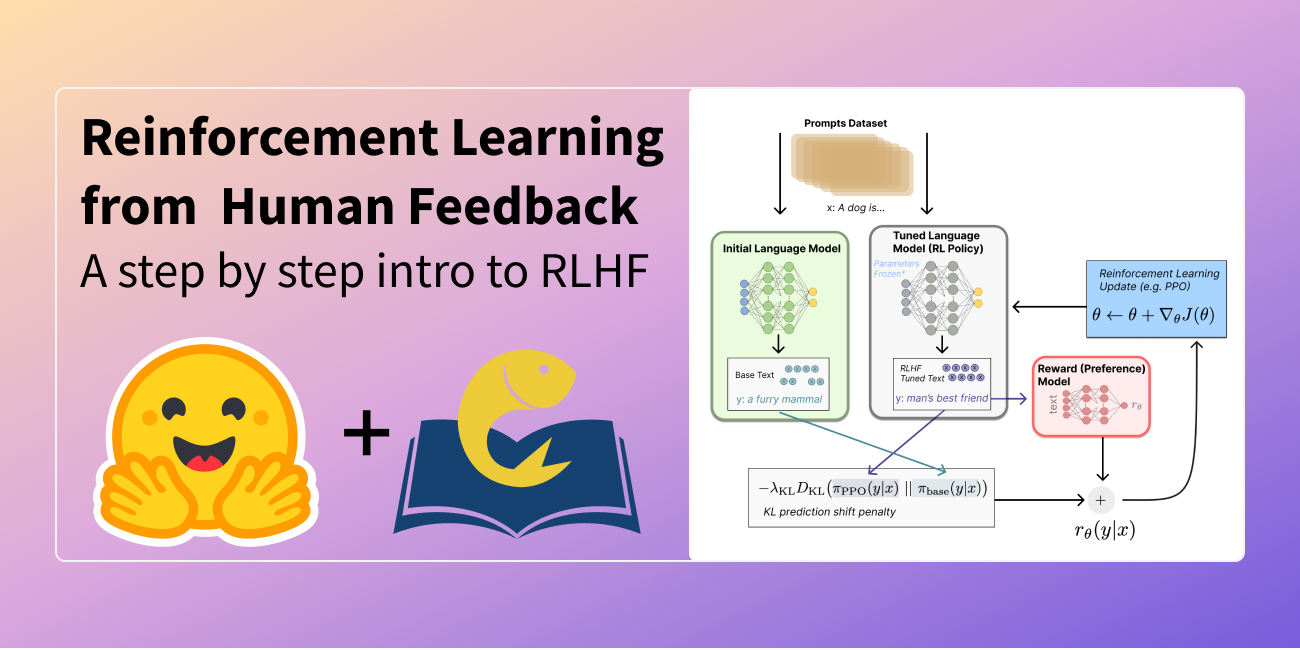
2022년 12월 9일에 게시됨
인간 피드백을 통한 강화 학습
